Um guia para entender e agir.
Este guia é para quem responde por venda, lead, CAC (custo de aquisição de cliente) e pelo funcionamento do site: dono, diretor de marketing, gerente de e-commerce, head de produto e líder de tecnologia. Você vai entender como o Google encontra e processa páginas, como facilitar o acesso dos rastreadores de IA, o que costuma falhar nesse caminho e o que pedir ao time de desenvolvimento. Consulte os capítulos conforme o problema ou comece pelo checklist. Cada frente reúne evidências com fonte e data, exemplos, erros comuns e ações práticas.
A TRIWI trabalha com SEO desde 2018 e integra a Otimização para IAs ao método de 12 etapas e mais de 300 atividades. O técnico é o primeiro dos quatro pilares. Para entender os fundamentos da busca, consulte o Guia de SEO; para os recursos próprios das IAs, o Guia de GEO. As revisões deste material ficam registradas no histórico ao fim da página.
SEO Técnico em 10 frases
- SEO técnico reúne ajustes na infraestrutura, no código e na arquitetura que facilitam o rastreamento, o processamento e a indexação do site pelos buscadores, além do acesso dos sistemas de IA ao conteúdo.
- É o primeiro dos quatro pilares do SEO: não cria demanda nem autoridade, mas decide se o conteúdo e a autoridade que a empresa já tem chegam inteiros ao índice e às respostas das IAs.
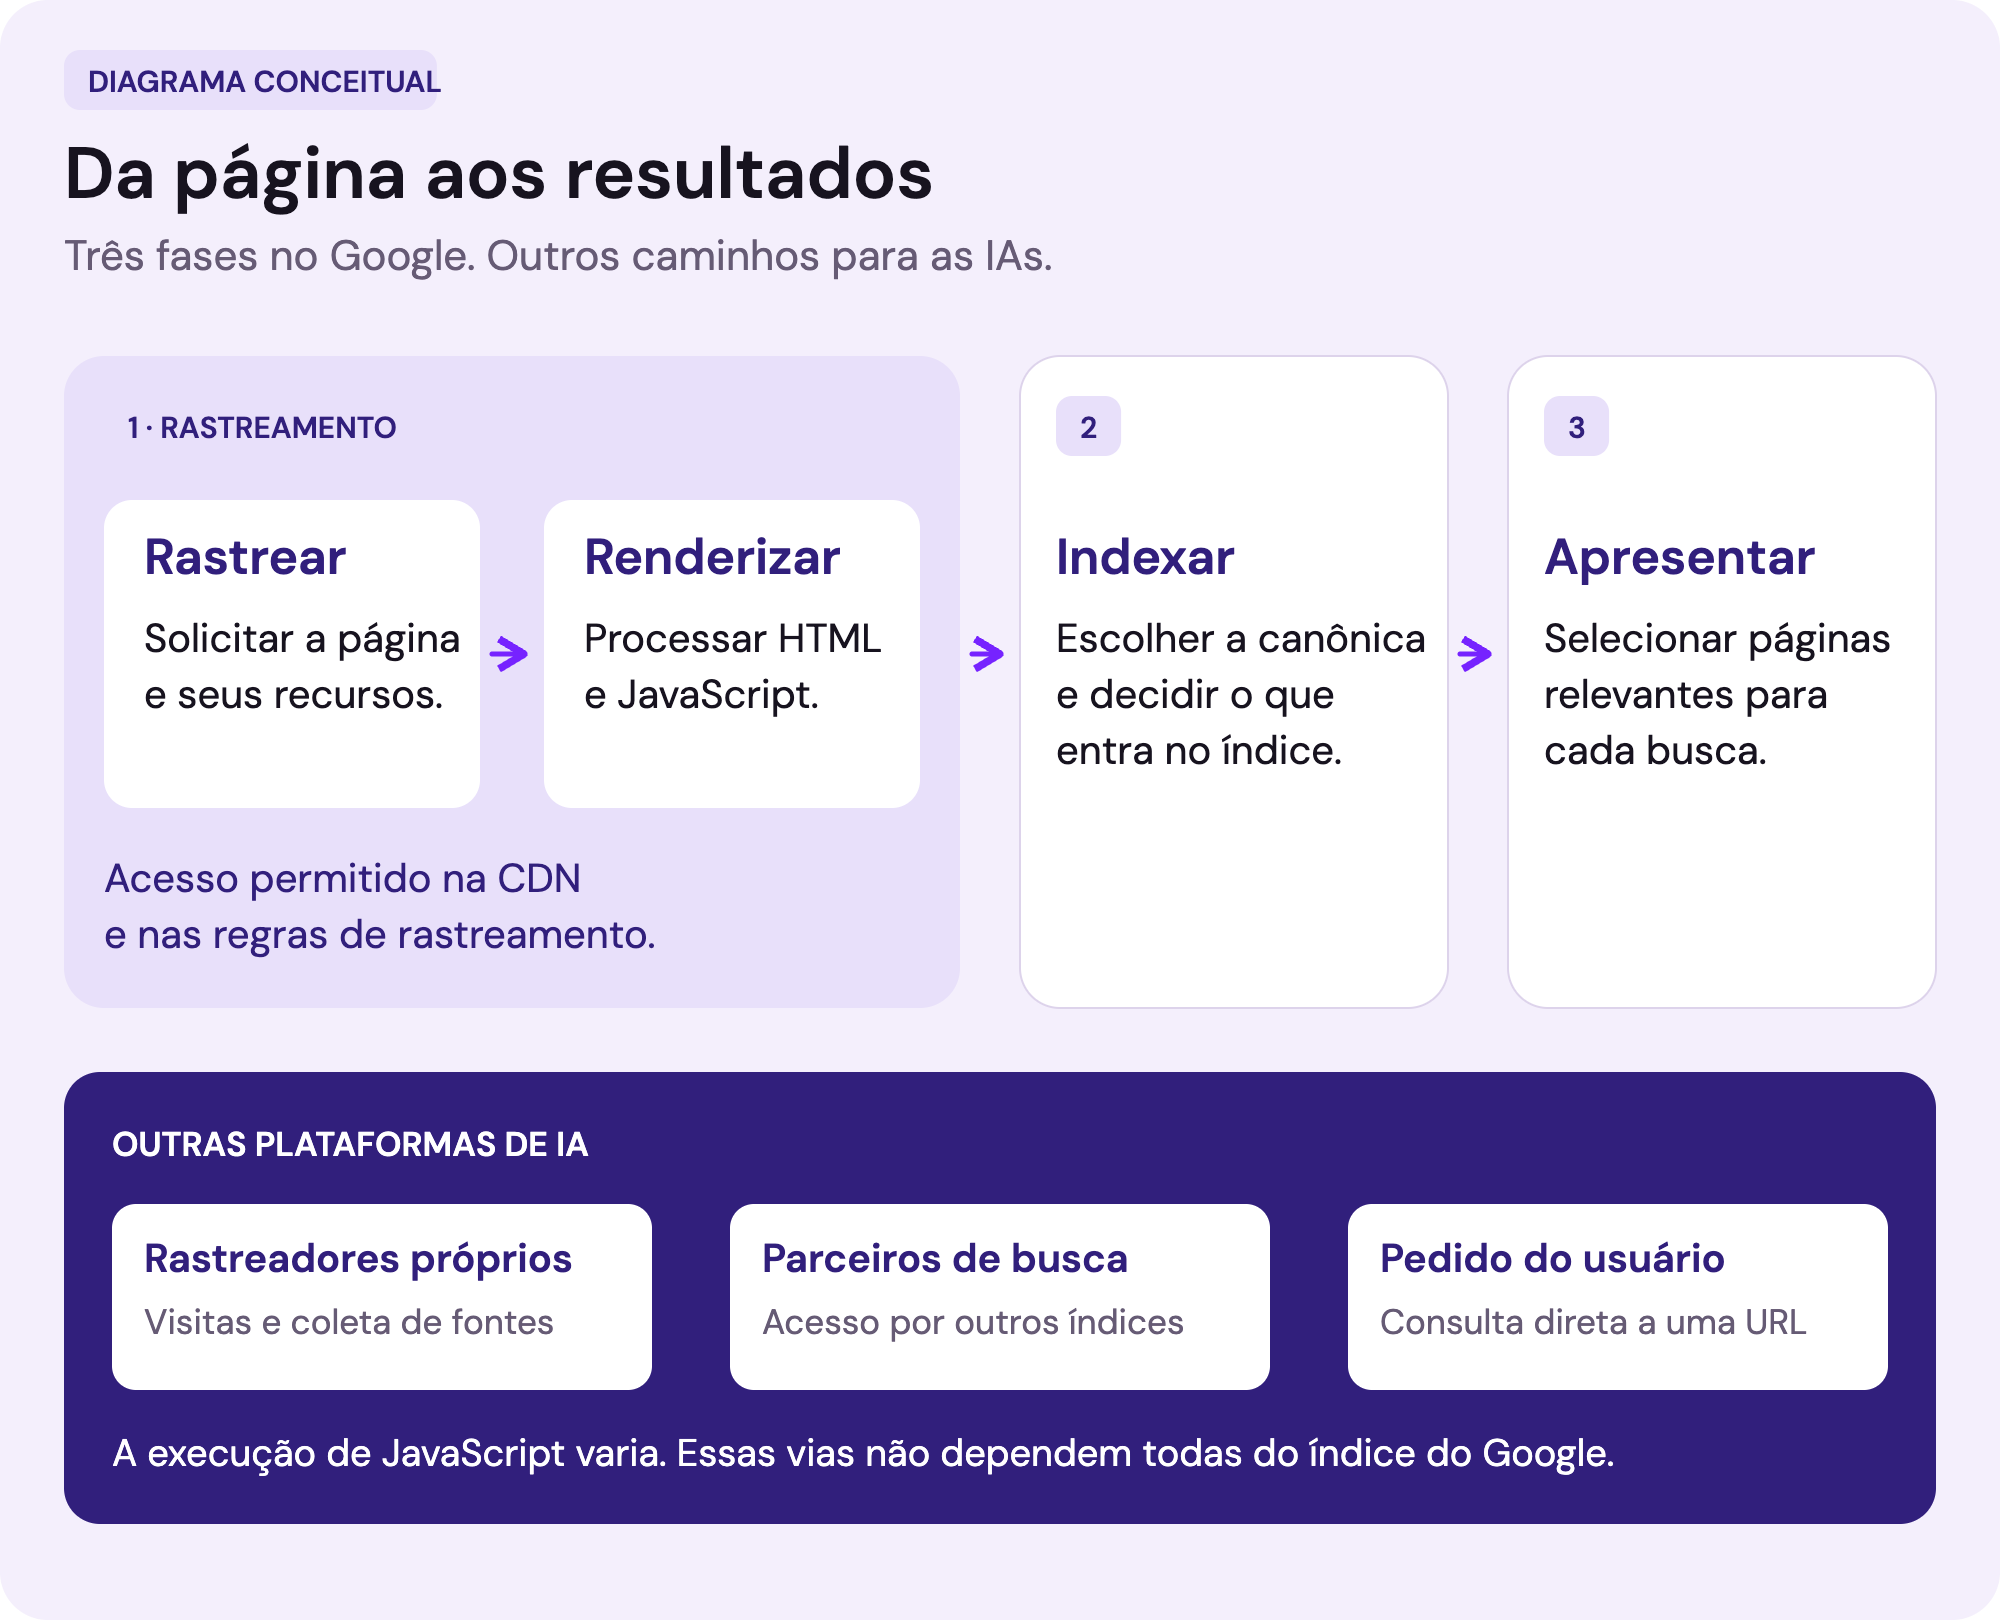
- A Busca do Google funciona em três fases: rastreamento, indexação e apresentação dos resultados; a renderização faz parte do processamento da página durante o rastreamento, e uma falha técnica pode impedir sua participação na busca.
- Rastrear não é indexar: o robots.txt controla por onde o rastreador passa, o noindex controla o que entra no índice, e usar um no lugar do outro é um dos erros mais caros.
- Desde julho de 2024, o Google rastreia e indexa como um celular (Google): o que não existe na versão mobile não existe para o índice.
- Entregar o conteúdo principal no HTML inicial facilita sua leitura por rastreadores que não executam JavaScript; as capacidades variam entre plataformas, e o estudo da Vercel e MERJ descreve o cenário observado em dezembro de 2024.
- Velocidade se mede com usuários reais: em 2025, 48% dos sites passavam nos três Core Web Vitals no celular (HTTP Archive, Web Almanac 2025).
- Um redirecionamento 301 por URL, para a página equivalente e em um salto, preserva os sinais; mandar tudo para a home faz o Google tratar a página como inexistente.
- Migração é o momento de maior risco: num site pequeno ou médio, o Google leva algumas semanas para mover a maior parte das páginas, e os redirecionamentos ficam por pelo menos um ano (Google).
- SEO técnico é manutenção contínua: cada publicação de código pode reabrir um problema fechado, e o que se corrige no modelo de página corrige o site inteiro.
- SEO (Search Engine Optimization)
- otimização para mecanismos de busca; GEO (Generative Engine Optimization): Otimização para IAs.
- HTML, CSS e JavaScript
- a estrutura da página, o visual e os scripts que rodam no navegador.
- URL, HTTP e HTTPS
- o endereço da página, o protocolo da web e a versão segura, com certificado; HSTS: a instrução que obriga o navegador a usar HTTPS.
- CDN
- rede de distribuição de conteúdo, os servidores intermediários que entregam o site e podem barrar rastreadores.
- CMS
- o sistema de gestão de conteúdo, a plataforma onde o site é editado.
- SSR (server-side rendering)
- renderização no servidor, que entrega a página montada no HTML.
- API
- a interface pela qual um sistema consulta outro; JSON-LD: o formato de dados estruturados recomendado pelo Google.
- Core Web Vitals
- LCP (tempo até o maior elemento visível aparecer), INP (tempo de resposta a cliques e toques) e CLS (estabilidade visual); FID: a métrica que o INP substituiu.
- CrUX (Chrome User Experience Report)
- a base de dados de usuários reais do Chrome; TTFB: o tempo até o primeiro byte da resposta do servidor.
- 4xx e 5xx
- as famílias de códigos de resposta de página inexistente e de erro do servidor.
- hreflang
- a marcação que indica a versão de cada página por idioma e país.
- E-E-A-T
- experiência, expertise, autoridade e confiança, os critérios de qualidade do Google.
- GA4, CAC e PDCA
- a ferramenta de medição do Google, o custo de aquisição de cliente e o ciclo planejar, executar, checar e agir.
- B2B e SaaS
- venda entre empresas e software vendido como serviço; MB, KB e KiB: unidades de tamanho de arquivo.
- Rastreador (crawler)
- o programa que visita e lê as páginas, como o Googlebot; modelo de página (template): o molde que gera todas as páginas de um mesmo tipo, como as de produto.
O que é SEO Técnico
SEO técnico é o conjunto de ajustes na infraestrutura, no código e na arquitetura de um site que facilitam seu rastreamento, processamento e indexação pelos buscadores, além do acesso dos sistemas de IA ao conteúdo. Ele não cria demanda nem autoridade: ajuda o conteúdo e os sinais que a empresa já tem a serem encontrados e compreendidos.
É o primeiro dos quatro pilares do SEO, como o Guia de SEO os descreve: técnico, conteúdo, autoridade e Otimização para IAs. Os outros três dependem dele. Um texto que o Googlebot não consegue acessar ou processar pode ficar fora da busca; um backlink para uma URL presa em um loop de redirecionamento não leva ao conteúdo esperado; uma loja com milhares de URLs de filtro gasta o rastreamento em páginas que nunca vão vender.

O que entra e o que não entra
Entra tudo o que fica entre o servidor e o índice. Não entra o que é conteúdo nem o que é autoridade; esses assuntos têm guias próprios. E SEO técnico não é sinônimo de velocidade, embora velocidade seja parte dele: muitos dos problemas que custam tráfego não aparecem no PageSpeed Insights, aparecem no log do servidor e no relatório de indexação do Search Console.
O que é e o que não é SEO técnico
| Entra no SEO técnico | Fica em outro pilar |
|---|---|
| Rastreamento: o Google e as IAs conseguem chegar e ler | Palavra-chave e intenção de busca (conteúdo) |
| Indexação: a página certa entra no índice, uma vez só | Texto, estrutura e atualização das páginas (conteúdo) |
| Arquitetura e links internos: o Google entende o que é importante | Links de outros sites, menções e avaliações (autoridade) |
| Velocidade e Core Web Vitals | Presença nas fontes que as IAs consultam (Otimização para IAs) |
| Versão mobile e JavaScript: o Google vê o que o usuário vê | Imprensa, vídeo e redes sociais (autoridade) |
| Dados estruturados, HTTPS, códigos de resposta, migrações e escala | Medição de presença nas respostas das IAs (Otimização para IAs) |
Por que importa para o negócio
Porque falha técnica é silenciosa e multiplica: um noindex esquecido numa homologação que foi ao ar, uma regra de CDN que bloqueia rastreadores, uma categoria que responde erro em horário de pico, um redirecionamento que manda tudo para a home. Nenhum desses erros derruba o site para o usuário, e todos derrubam a posição.
Também importa porque o acesso ao conteúdo varia entre os sistemas de IA. No estudo da Vercel e MERJ publicado em dezembro de 2024, a maioria dos grandes rastreadores de IA analisados não executava JavaScript; as exceções relatadas eram o Gemini, associado à infraestrutura do Googlebot, e o rastreador da Apple. É um retrato daquela coleta, não uma regra permanente para todas as plataformas. Entregar o conteúdo principal no HTML inicial reduz a dependência de renderização. O Guia de GEO trata dos rastreadores de IA, do llms.txt e dos controles de trecho.
O que mostram as páginas do topo do Google
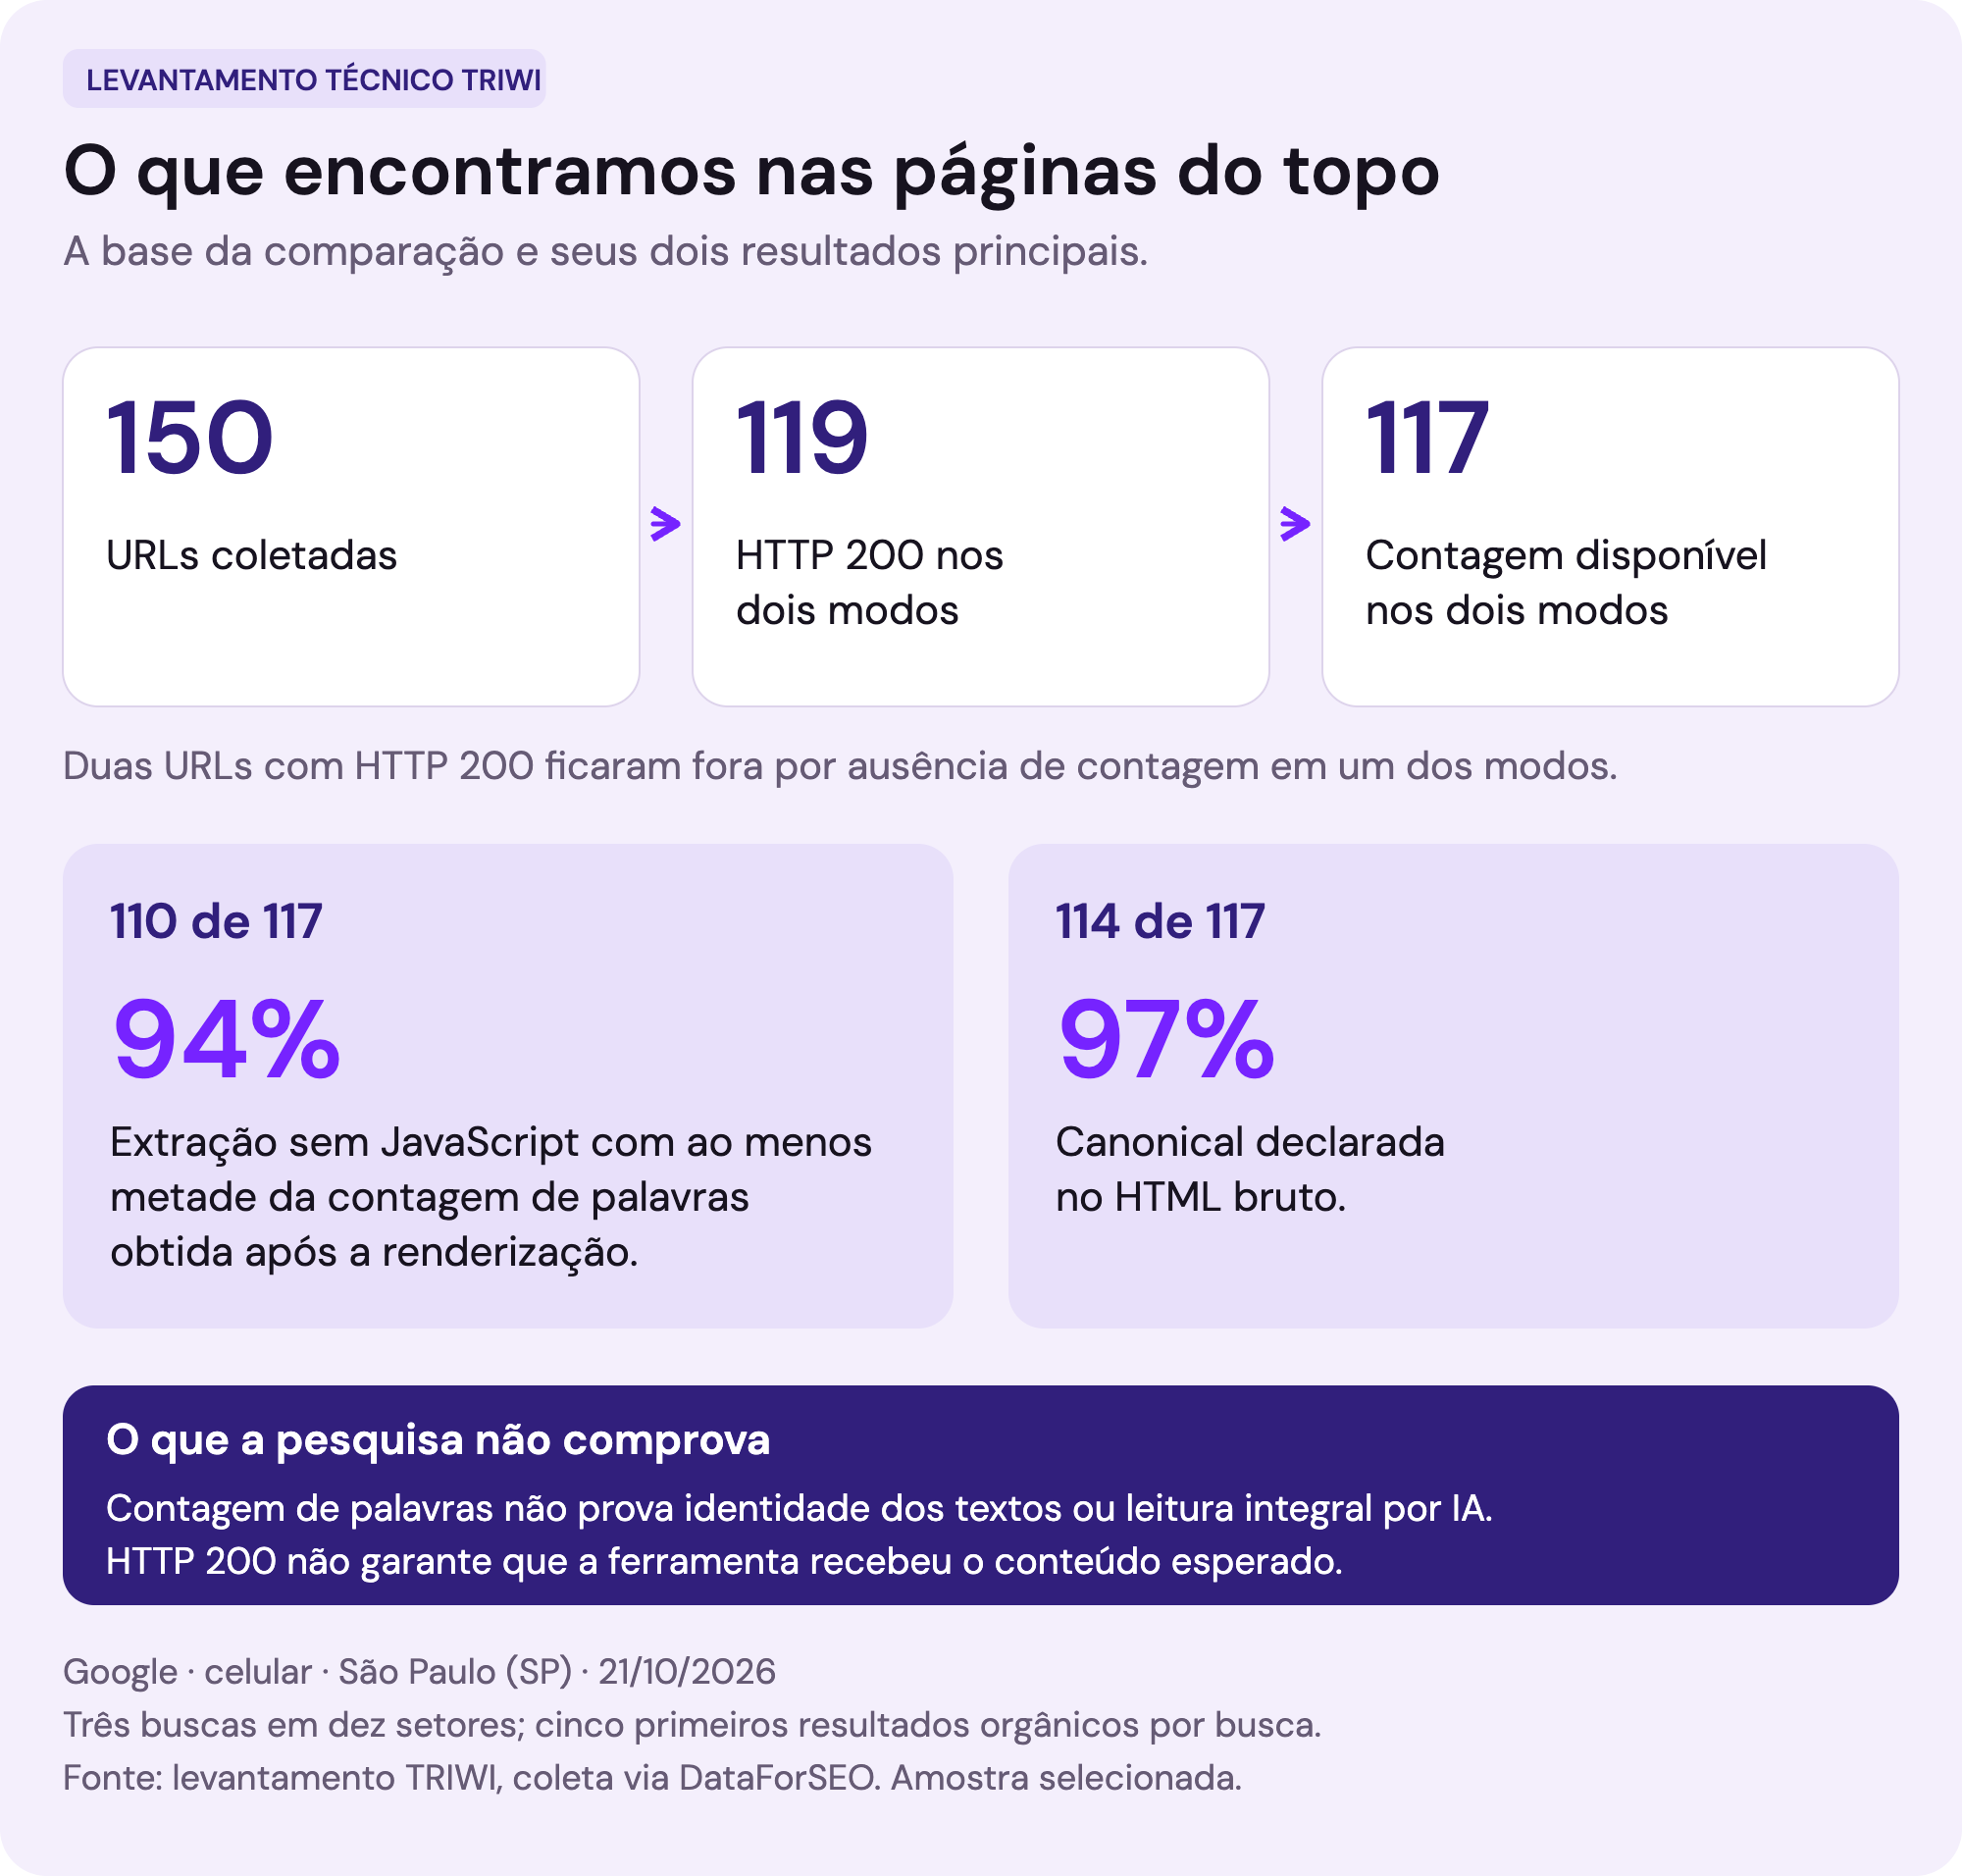
Para saber como estão tecnicamente as páginas que já vencem a busca no Brasil, o levantamento técnico TRIWI examinou os primeiros resultados. Método: três buscas comerciais por setor em dez setores (saúde, finanças, software, contabilidade, jurídico, imóveis, educação, seguros, indústria e e-commerce), coletadas em 21 de outubro de 2026 no Google, no celular, com localização em São Paulo (SP), via API de SERP da DataForSEO. As cinco primeiras posições orgânicas de cada busca somaram 150 URLs únicas. A API On-Page da DataForSEO tentou ler cada URL em dois modos: sem e com execução de JavaScript. Para comparar contagens de palavras e atributos, o recorte considerou 117 páginas com resposta HTTP 200 registrada pela ferramenta e contagem de palavras disponível nos dois modos. Duas das 119 URLs com HTTP 200 nos dois modos ficaram fora dessa comparação por ausência de contagem em pelo menos um deles. É uma amostra selecionada, não uma estimativa para a web brasileira. A ferramenta não é o Googlebot nem um rastreador de IA; resposta 200 e contagem disponível não comprovam acesso integral ao conteúdo esperado. Os dados brutos estão guardados para conferência.

Os sinais de que há problema técnico
O decisor não precisa abrir o código para desconfiar. Os sinais que pedem uma investigação técnica: o número de páginas indexadas cai de uma semana para outra; uma página nova leva semanas para aparecer; uma categoria some da busca depois de uma publicação; o tráfego orgânico cai logo após uma troca de tema, de CDN ou de plataforma; o Search Console acusa erros de servidor ou de redirecionamento; a marca não aparece nas respostas das IAs mesmo com conteúdo forte. Cada um é um sinal para investigar, não um diagnóstico: o capítulo “Checklist de SEO técnico” mostra por onde começar.
↗ Na prática
- Peça ao time de desenvolvimento o acesso ao Search Console e ao log do servidor: são as duas fontes de verdade deste guia.
- Compare, no relatório de indexação de páginas do Search Console, o número de páginas indexadas com o número de páginas que deveriam vender; a diferença é o tamanho do problema.
- Teste as cinco páginas mais importantes com JavaScript desligado e no celular: o que sumir não existe para parte dos rastreadores.
- Trate SEO técnico como manutenção contínua, não como projeto de uma vez: cada publicação de código pode reabrir um problema fechado.
Rastreamento
Rastreamento é a visita: o Googlebot descobre URLs (por links, sitemaps e redirecionamentos), decide quais buscar, baixa o HTML e, depois, os recursos que a página referencia (CSS, JavaScript, imagens), cada um numa requisição própria. Se o rastreador não chega, nada do que vem depois acontece.
Como o Googlebot lê o site
Desde fevereiro de 2026, a documentação do Google detalha que o Googlebot, quando rastreia para a Busca, lê os primeiros 2 MB de cada tipo de arquivo compatível, o HTML incluído, e os primeiros 64 MB de um PDF; só a parte baixada segue para a indexação. O limite vale para o arquivo sem compressão e para cada recurso em separado. Os 15 MB que a documentação citava antes continuam como limite padrão dos outros rastreadores do Google, e o próprio Google tratou a mudança como esclarecimento, não como mudança de comportamento. Para a maioria dos sites é folga; para páginas com o catálogo inteiro no HTML ou código pesado de construtor de página, não é.
O Googlebot rastreia como celular, respeita o robots.txt e ajusta o ritmo ao servidor: respostas 5xx e 429 fazem o rastreador desacelerar, e ele volta ao ritmo normal aos poucos, quando o site responde bem de novo.
Orçamento de rastreamento
O Google chama de crawl budget (orçamento de rastreamento) a combinação de dois limites: o que o servidor aguenta sem degradar (capacidade) e o quanto o Google quer rastrear o site (demanda, que cresce com popularidade e frescor). Pela estimativa do próprio Google, é preocupação de sites com mais de um milhão de páginas que mudam toda semana, ou a partir de dez mil páginas que mudam todo dia, e de sites com boa parte das URLs paradas em “Descoberta, atualmente não indexada”.
Para os demais, o problema é outro: o Google gasta visitas em URLs que não vendem e demora a ver as que vendem. As fontes clássicas de desperdício: facetas e parâmetros de ordenação que geram milhares de combinações, busca interna rastreável, calendários infinitos, versões com e sem barra final, soft 404 (página vazia que responde como se existisse), cadeias de redirecionamento e páginas lentas.
Robots.txt: o que bloquear e o que nunca bloquear
O robots.txt diz ao rastreador por onde não entrar. Ele bloqueia rastreamento, não indexação: uma URL bloqueada pode continuar no índice se receber links, e o Google ignora noindex dentro do robots.txt desde setembro de 2019. Para tirar uma página do índice, usa-se noindex na própria página; para poupar rastreamento de áreas inúteis, usa-se o robots.txt. O Google guarda o robots.txt em cache por até 24 horas e lê só os primeiros 500 KiB do arquivo. Se o arquivo responder com erro de servidor, o Google para de rastrear o site por meio dia e, por até um mês, usa a última cópia que tem.
O que bloquear e o que nunca bloquear no robots.txt
| Bloquear (poupa rastreamento) | Nunca bloquear | Por quê |
|---|---|---|
| Carrinho, checkout e área de conta | Arquivos CSS e JavaScript | Sem eles, o Google não renderiza a página como o usuário a vê |
| Busca interna e suas combinações | Imagens dos produtos e das páginas | Imagem bloqueada não aparece na busca de imagens nem nos resultados ricos |
| Ordenação e combinações de facetas sem demanda de busca | Páginas que levam noindex | Bloqueada, a página não é lida, e o noindex nunca é visto |
| Ambientes de teste (com senha; o robots.txt sozinho não basta) | Os rastreadores que a empresa quer receber, inclusive os de IA | Bloqueio por engano tira o site da busca ou das respostas sem aviso |
O log do servidor e a CDN
O log do servidor mostra as requisições que chegaram à origem: quem entrou, em que URL, com que resposta e em quanto tempo. Para enxergar o caminho completo, cruze esses registros com os logs da CDN e os eventos do firewall. Requisições atendidas pelo cache ou bloqueadas na borda podem não chegar ao servidor e, por isso, não aparecem no log da origem. Essa comparação ajuda a localizar o rastreamento gasto em filtros, os erros de resposta e os bloqueios de rastreadores. Confira também a identidade do robô pelos mecanismos de verificação publicados pelo provedor, pois o nome informado no user agent, sozinho, pode ser imitado.
Quando a CDN mostra uma página de verificação de robô, é só isso que o rastreador vê. O Google recomenda responder 503 nesses casos e conferir, pela inspeção de URL, se os rastreadores que importam acessam o site, porque os IPs deles podem cair em listas de bloqueio sem que ninguém perceba (Google, dezembro de 2024).
A liberação dos rastreadores de IA, e o que cada um faz, está no Guia de GEO.
↗ Na prática
- Compare no log o número de URLs rastreadas por dia com o número de páginas que vendem: se a maior parte das visitas vai para filtro, busca e parâmetro, o orçamento está sendo gasto no lugar errado.
- Bloqueie no robots.txt o que não precisa ser rastreado e mantenha CSS e JavaScript necessários à renderização liberados. Se o objetivo for retirar uma URL da busca, deixe o rastreador acessar o noindex; bloquear no robots.txt não garante essa retirada. Proteja áreas privadas com autenticação.
- Acompanhe nas estatísticas de rastreamento do Search Console o tempo de resposta e os erros 5xx; picos costumam coincidir com quedas de rastreamento.
- Peça ao responsável pela CDN a lista de robôs que a regra de proteção deixa passar, e quem decidiu essa lista.
- Mantenha o HTML principal enxuto e longe do limite: catálogo, scripts e CSS vão em recursos separados.
Indexação
Indexar é guardar: o Google decide se a página entra no índice, com que versão (a canônica) e sob quais sinais. Rastreamento não é indexação: boa parte das URLs rastreadas de um site grande fica de fora por ser duplicada, vazia, bloqueada ou considerada sem valor. Fora do índice do Google, a página não participa dos resultados da Busca nem é elegível como link de apoio em AI Overviews e AI Mode. Outras plataformas de IA podem usar índices, rastreadores e formas de acesso próprios; estar fora do Google não determina, sozinho, se elas conseguirão acessar ou citar a página.
Canônica, duplicata e o que o Google escolhe
Toda página tem uma URL canônica, a versão que o Google trata como oficial quando há cópias: com e sem www, com parâmetro de campanha, com variação de cor, em HTTP e em HTTPS. A tag canonical é a sugestão do site; o Google pode escolher outra se os sinais (links internos, sitemap, redirecionamentos, conteúdo) apontarem em outra direção, e o Search Console avisa com “Duplicada, o Google escolheu uma canônica diferente”. A regra: uma URL por conteúdo, canônica apontando para si mesma e os demais sinais em acordo com ela.
Noindex, robots e X-Robots-Tag
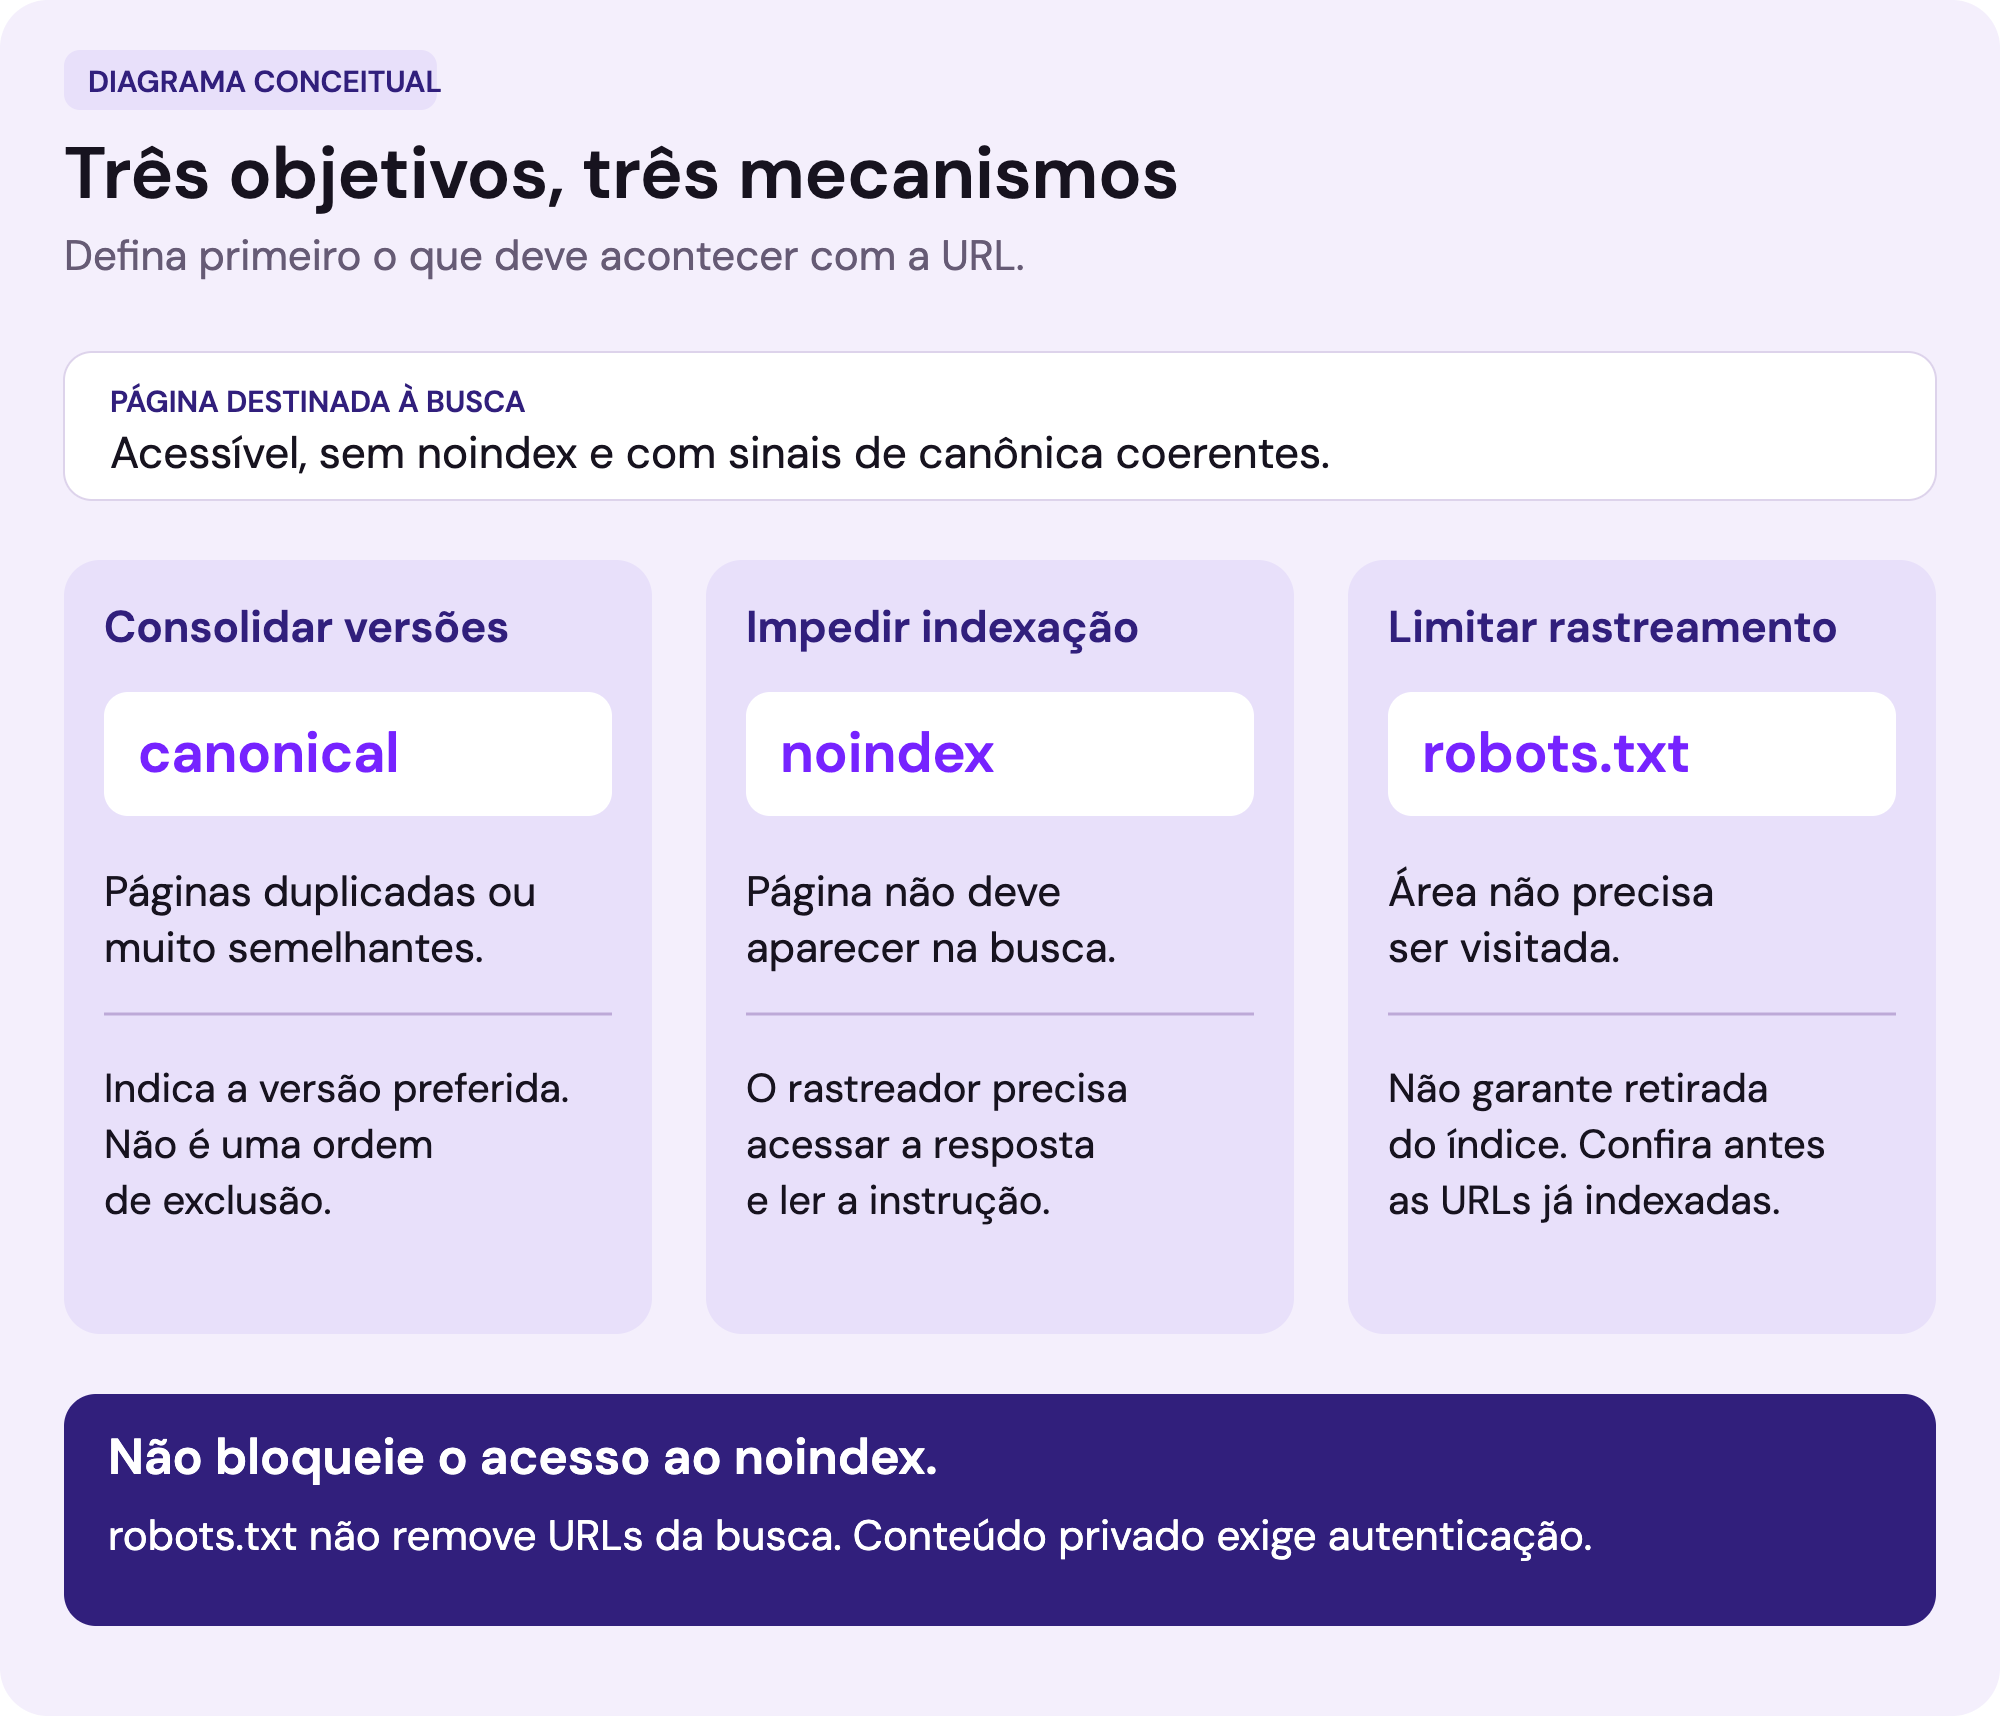
O noindex é a instrução para não indexar, na meta robots da página ou no cabeçalho HTTP X-Robots-Tag, que também pode ser usado em recursos como PDFs e imagens. Serve para páginas que precisam existir mas não devem ranquear: páginas de agradecimento, versões de impressão e filtros sem demanda que já estão no índice. O rastreador precisa acessar a resposta para ler a instrução. O robots.txt tem outro objetivo: limitar rastreamento, por exemplo em combinações de busca interna e filtros que não precisam ser visitadas. Ele não garante que uma URL fique fora da busca. Se a retirada do índice é necessária, não bloqueie o acesso ao noindex. Carrinho e área de conta exigem ainda os controles de acesso apropriados; conteúdo privado deve ficar protegido por autenticação.

Sitemap XML
O sitemap é a lista do que o site quer indexado: só URLs canônicas, indexáveis, que respondem com sucesso, com a data real de modificação em lastmod. Cada arquivo comporta até cinquenta mil URLs ou cinquenta megabytes sem compressão; sites maiores usam um índice de sitemaps, um arquivo por tipo de página (produtos, categorias, conteúdo), porque o Search Console reporta a indexação por sitemap. Sitemap com URL redirecionada, bloqueada ou com noindex é ruído que o Google aprende a desconsiderar. O Google ignora os campos priority e changefreq e usa o lastmod quando ele é confiável.
O relatório de indexação
O relatório de indexação de páginas do Search Console é o inventário: quantas páginas indexadas, quantas fora e por quê. “Descoberta, atualmente não indexada” quer dizer que o Google conhece a URL e ainda não a rastreou; segundo o Google, normalmente porque o rastreamento naquele momento poderia sobrecarregar o site, e ele o reagendou. Em volume, é sinal para investigar a capacidade do servidor e o rastreamento gasto em URLs que não vendem. “Rastreada, atualmente não indexada” quer dizer que a página foi lida, ficou fora e pode entrar mais tarde; quando se repete em páginas importantes, vale investigar conteúdo raso, duplicado ou sem links internos. “Soft 404” em volume costuma apontar para catálogo esgotado ou migração mal fechada, e a inspeção de URL confirma a causa caso a caso, com a canônica escolhida e o HTML renderizado.
Status do relatório de indexação: o que quer dizer e o que investigar
| Status | O que quer dizer | O que investigar |
|---|---|---|
| Descoberta, atualmente não indexada | O Google conhece a URL e ainda não a rastreou | Capacidade do servidor e URLs inúteis consumindo rastreamento |
| Rastreada, atualmente não indexada | Foi lida e ficou fora; pode entrar depois | Conteúdo raso ou duplicado, falta de links internos |
| Duplicada, o Google escolheu uma canônica diferente | Os sinais apontam para outra URL | Canônica, links internos, sitemap e redirecionamentos em desacordo |
| Excluída pela tag noindex | O site pediu para não indexar | Se a página deveria vender, é bloqueador |
| Soft 404 | A página parece vazia ou inexistente | Produto esgotado em branco, busca sem resultado, redirecionamento para a home |
| Erro de servidor (5xx) | O servidor falhou quando o Google visitou | Horário dos erros no log e capacidade nos picos |
O Bing Webmaster Tools tem relatório equivalente. O índice do Bing é a base de busca do Microsoft Copilot (Microsoft, 2026); o ChatGPT combina o próprio rastreador, o OAI-SearchBot, com parceiros de busca que a OpenAI não nomeia (OpenAI, central de ajuda).
Índice inchado
Índice inchado é o outro extremo: milhares de URLs indexadas sem valor (filtros, tags, paginação de busca) diluem a autoridade do site e consomem rastreamento. A medida saudável não é “quantas páginas indexadas”, é “todas as páginas que vendem indexadas e nenhuma das que não vendem”.
↗ Na prática
- Audite as canônicas das páginas de categoria e de produto: a URL do sitemap, a do link interno e a da tag canonical precisam ser a mesma.
- Crie um alerta para a contagem de páginas indexadas e para a presença de noindex nas páginas principais; queda abrupta é incidente, não tendência.
- Divida o sitemap por tipo de página e tire dele tudo o que redireciona, está bloqueado ou leva noindex.
- Revise todo mês os motivos de “não indexada” e trate os três mais frequentes.
Mobile e JavaScript
O Google usa a versão mobile para indexação e consegue executar JavaScript. Por isso, conteúdo ausente nessa versão pode ficar fora do índice, e conteúdo que só aparece depois de um script depende do processamento da página. Outros sistemas de IA têm capacidades diferentes: rastreadores que não executam JavaScript precisam encontrar a informação na resposta inicial ou por outras fontes de acesso.
Indexação mobile-first
Desde 5 de julho de 2024, o Google rastreia e indexa com o Googlebot Smartphone, e avisou que site inacessível pelo celular deixa de ser indexável. Isso exige paridade: o mesmo conteúdo, os mesmos links internos, os mesmos dados estruturados e as mesmas metas nas duas versões. Site responsivo resolve a paridade por desenho; versões separadas (“m.”) e layouts que escondem blocos inteiros no celular perdem o que ranqueava no desktop. Conteúdo em abas e acordeões pode ficar fechado por padrão, desde que esteja no HTML.
Uma exigência vem junto: intersticiais intrusivos (pop-ups que cobrem a tela logo na chegada) contam contra a experiência de página e, segundo o Google, dificultam que ele entenda o conteúdo; avisos legais e de cookies em tamanho razoável, não.
Como o Google processa JavaScript
O Google documenta três fases: rastrear, renderizar e indexar. O HTML é rastreado primeiro; a página entra numa fila de renderização, onde uma versão sempre atualizada do Chromium executa os scripts; só então o conteúdo gerado por JavaScript é indexado. A fila pode levar segundos ou bem mais do que isso, e páginas que respondem com código de erro podem nem ser renderizadas. Até a renderização acontecer, o Google conhece só o que estava no HTML inicial. Desde dezembro de 2025, a documentação traz duas regras que pegam muitos sites: se o HTML original tem noindex, o Google pode pular a renderização, e um script que retire o noindex depois não é lido; e a canônica precisa ser a mesma no HTML original e na versão renderizada.
O que quebra nesse caminho: conteúdo que só carrega depois de um clique, rolagem ou interação; links sem href (botões com evento de clique não são links para o rastreador); navegação por fragmento (#), que o Google em geral não trata como URL diferente; scripts e CSS bloqueados no robots.txt; listas de produtos e textos de categoria montados só no navegador, a partir de uma API; e erros de JavaScript que interrompem a renderização.
O que quebra a renderização e como testar
| Problema | O que um rastreador sem JavaScript vê | Como testar |
|---|---|---|
| Conteúdo carregado só depois de clique ou rolagem | A área vazia | Navegador com JavaScript desligado e inspeção de URL |
| Link em botão sem href | Nenhum link para seguir | Rastreador sem JavaScript: as páginas de destino não aparecem |
| Navegação por fragmento (#) | Um endereço só para todos os conteúdos | Conferir se cada conteúdo tem URL própria |
| CSS ou JavaScript bloqueado no robots.txt | Página sem layout ou sem conteúdo | Inspeção de URL, na lista de recursos bloqueados |
| Lista de produtos montada no navegador a partir de uma API | Categoria sem produtos | Código-fonte da categoria, antes de qualquer script |
| noindex no HTML original retirado por script | A página com noindex | Código-fonte original da página |
SSR, pré-renderização e as IAs
Uma forma de reduzir a dependência de JavaScript é entregar o conteúdo principal no HTML inicial, por renderização no servidor (SSR), geração estática ou pré-renderização, com o JavaScript assumindo depois (hidratação, quando o script assume a página já montada). Frameworks modernos (React, Next.js, Vue, Angular) e lojas headless (com a vitrine separada da plataforma) permitem essas estratégias quando configurados para isso. O conteúdo fica disponível antes da execução dos scripts, tanto para o Google quanto para rastreadores que não executam JavaScript. Isso facilita o acesso, mas não garante indexação nem citação por IA.
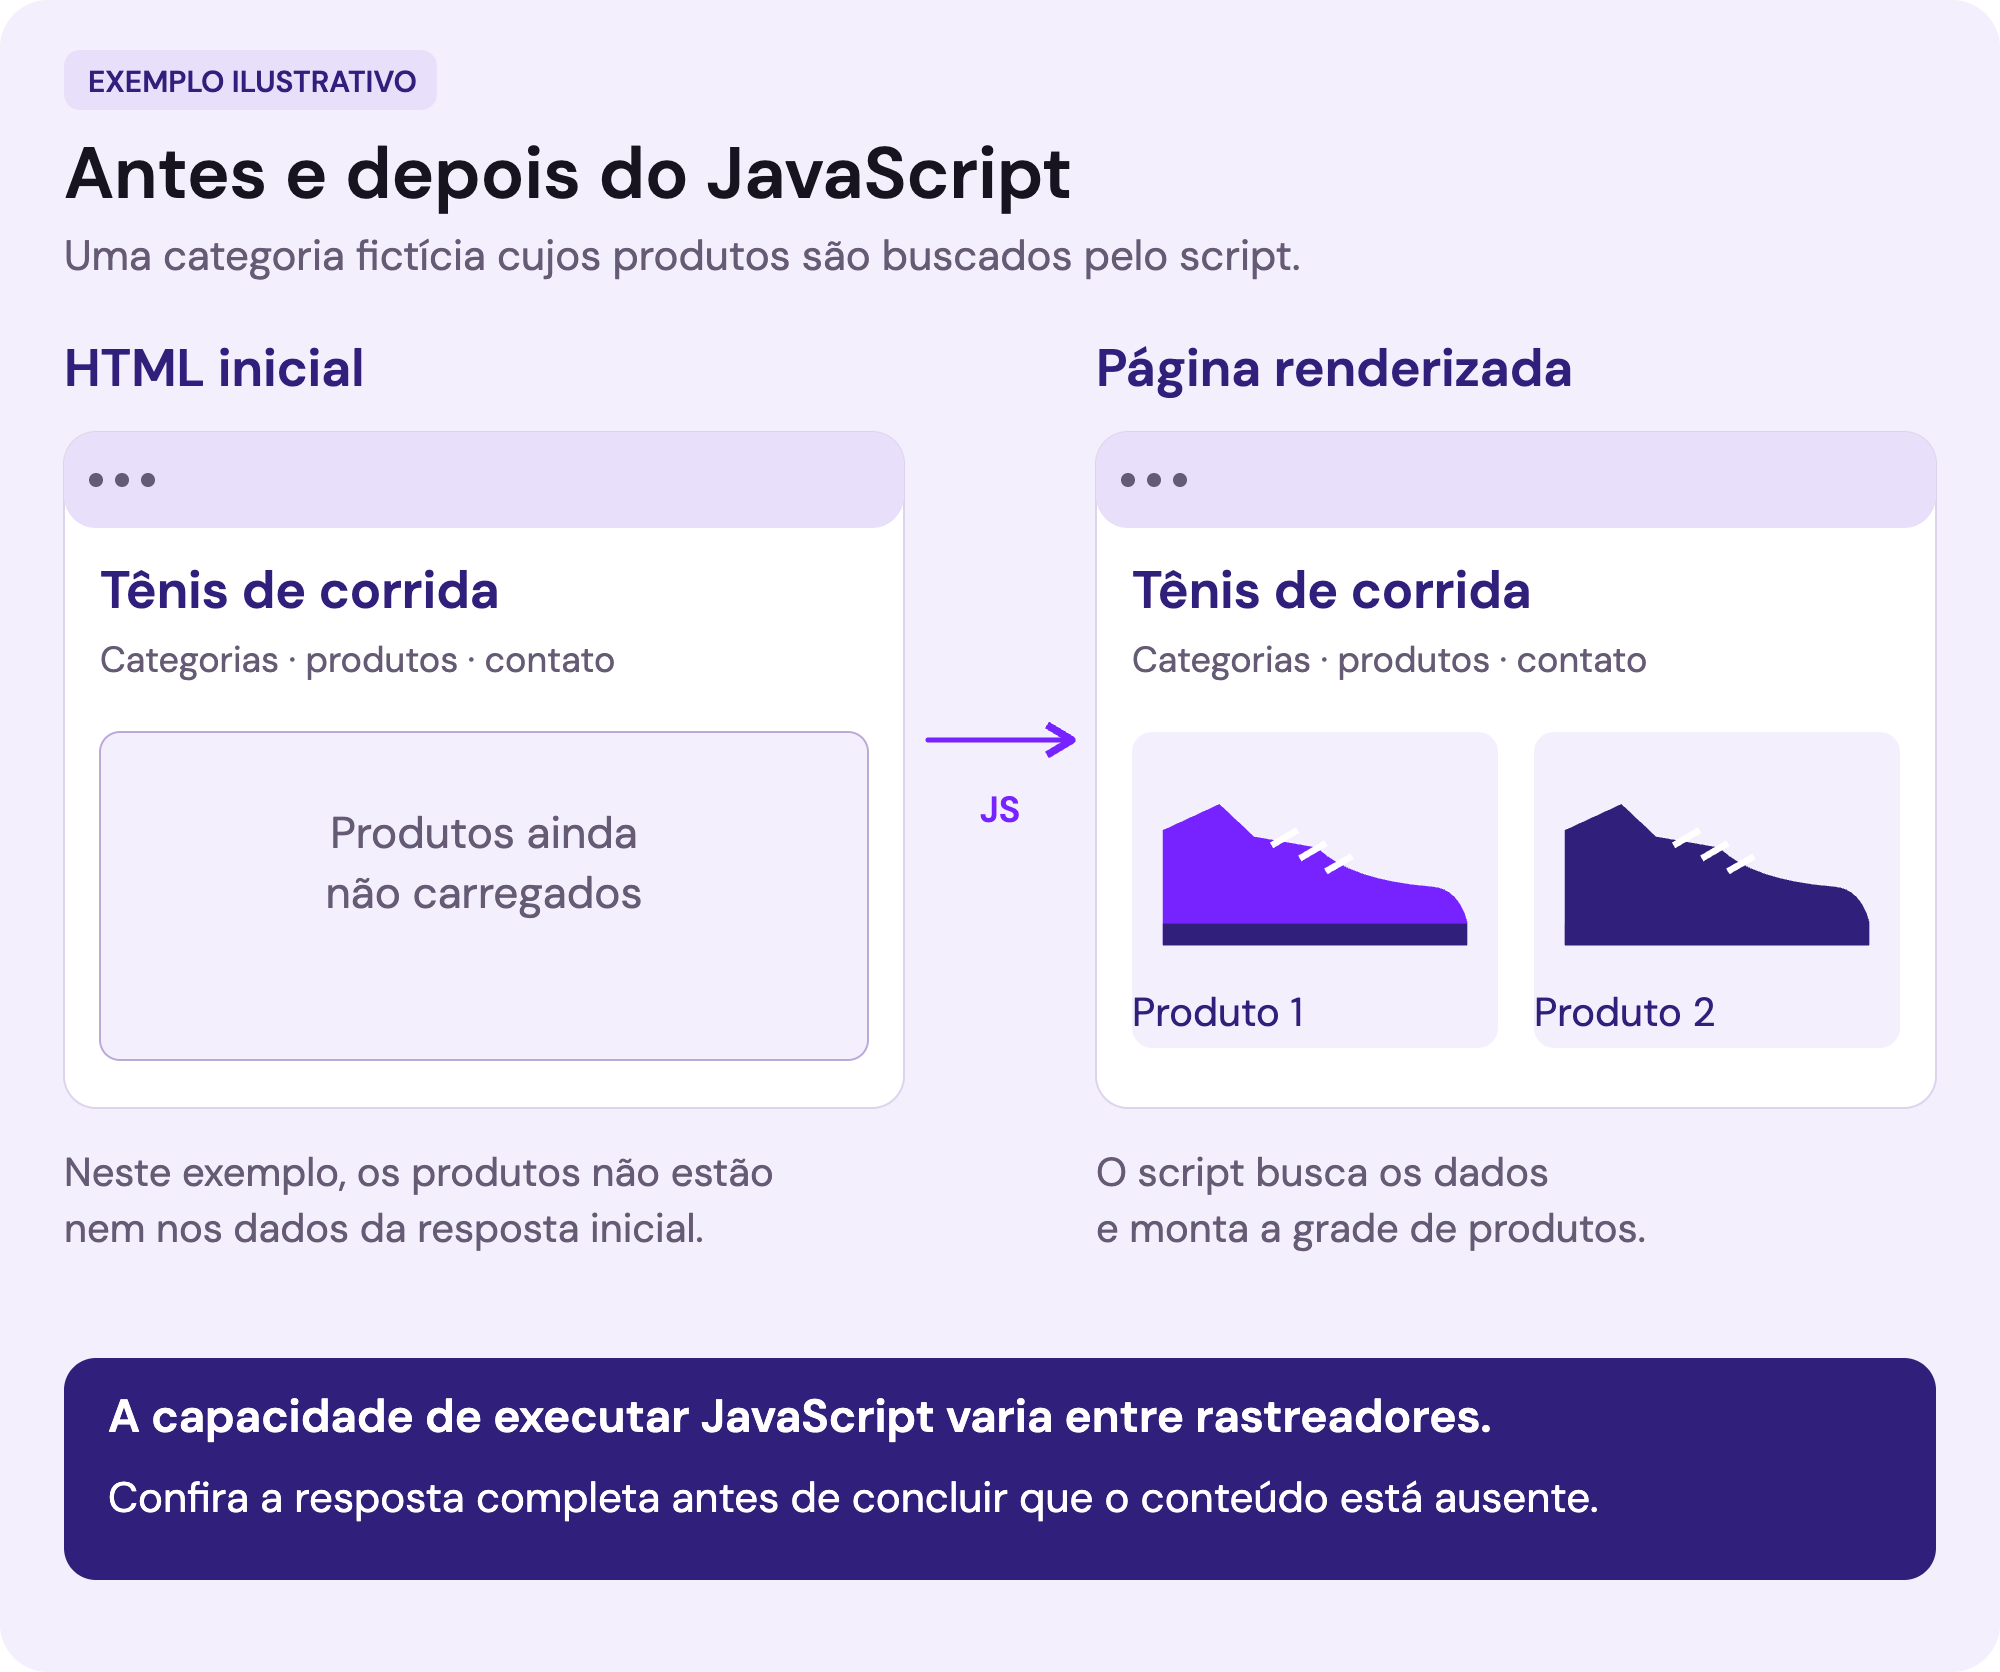

O teste é simples: a inspeção de URL do Search Console mostra o HTML renderizado e os recursos bloqueados; um navegador com JavaScript desligado mostra o que os rastreadores sem renderização enxergam. Em tecnologia e SaaS, onde o site costuma ser uma aplicação, este capítulo é o que mais decide o resultado.
↗ Na prática
- Confira a paridade entre celular e desktop nas páginas principais: texto, links internos, dados estruturados e metas.
- Rode a inspeção de URL nas páginas que vendem e compare o HTML renderizado com o que o usuário vê; o que faltar é problema de JavaScript.
- Abra o site com JavaScript desligado: menu, categorias, produtos e textos precisam aparecer.
- Confira que noindex e canônica saem do servidor, iguais no HTML bruto e na página renderizada.
- Peça ao time de desenvolvimento renderização no servidor ou pré-renderização para os modelos de página que vendem, e links sempre como âncora com href.
Arquitetura e links internos
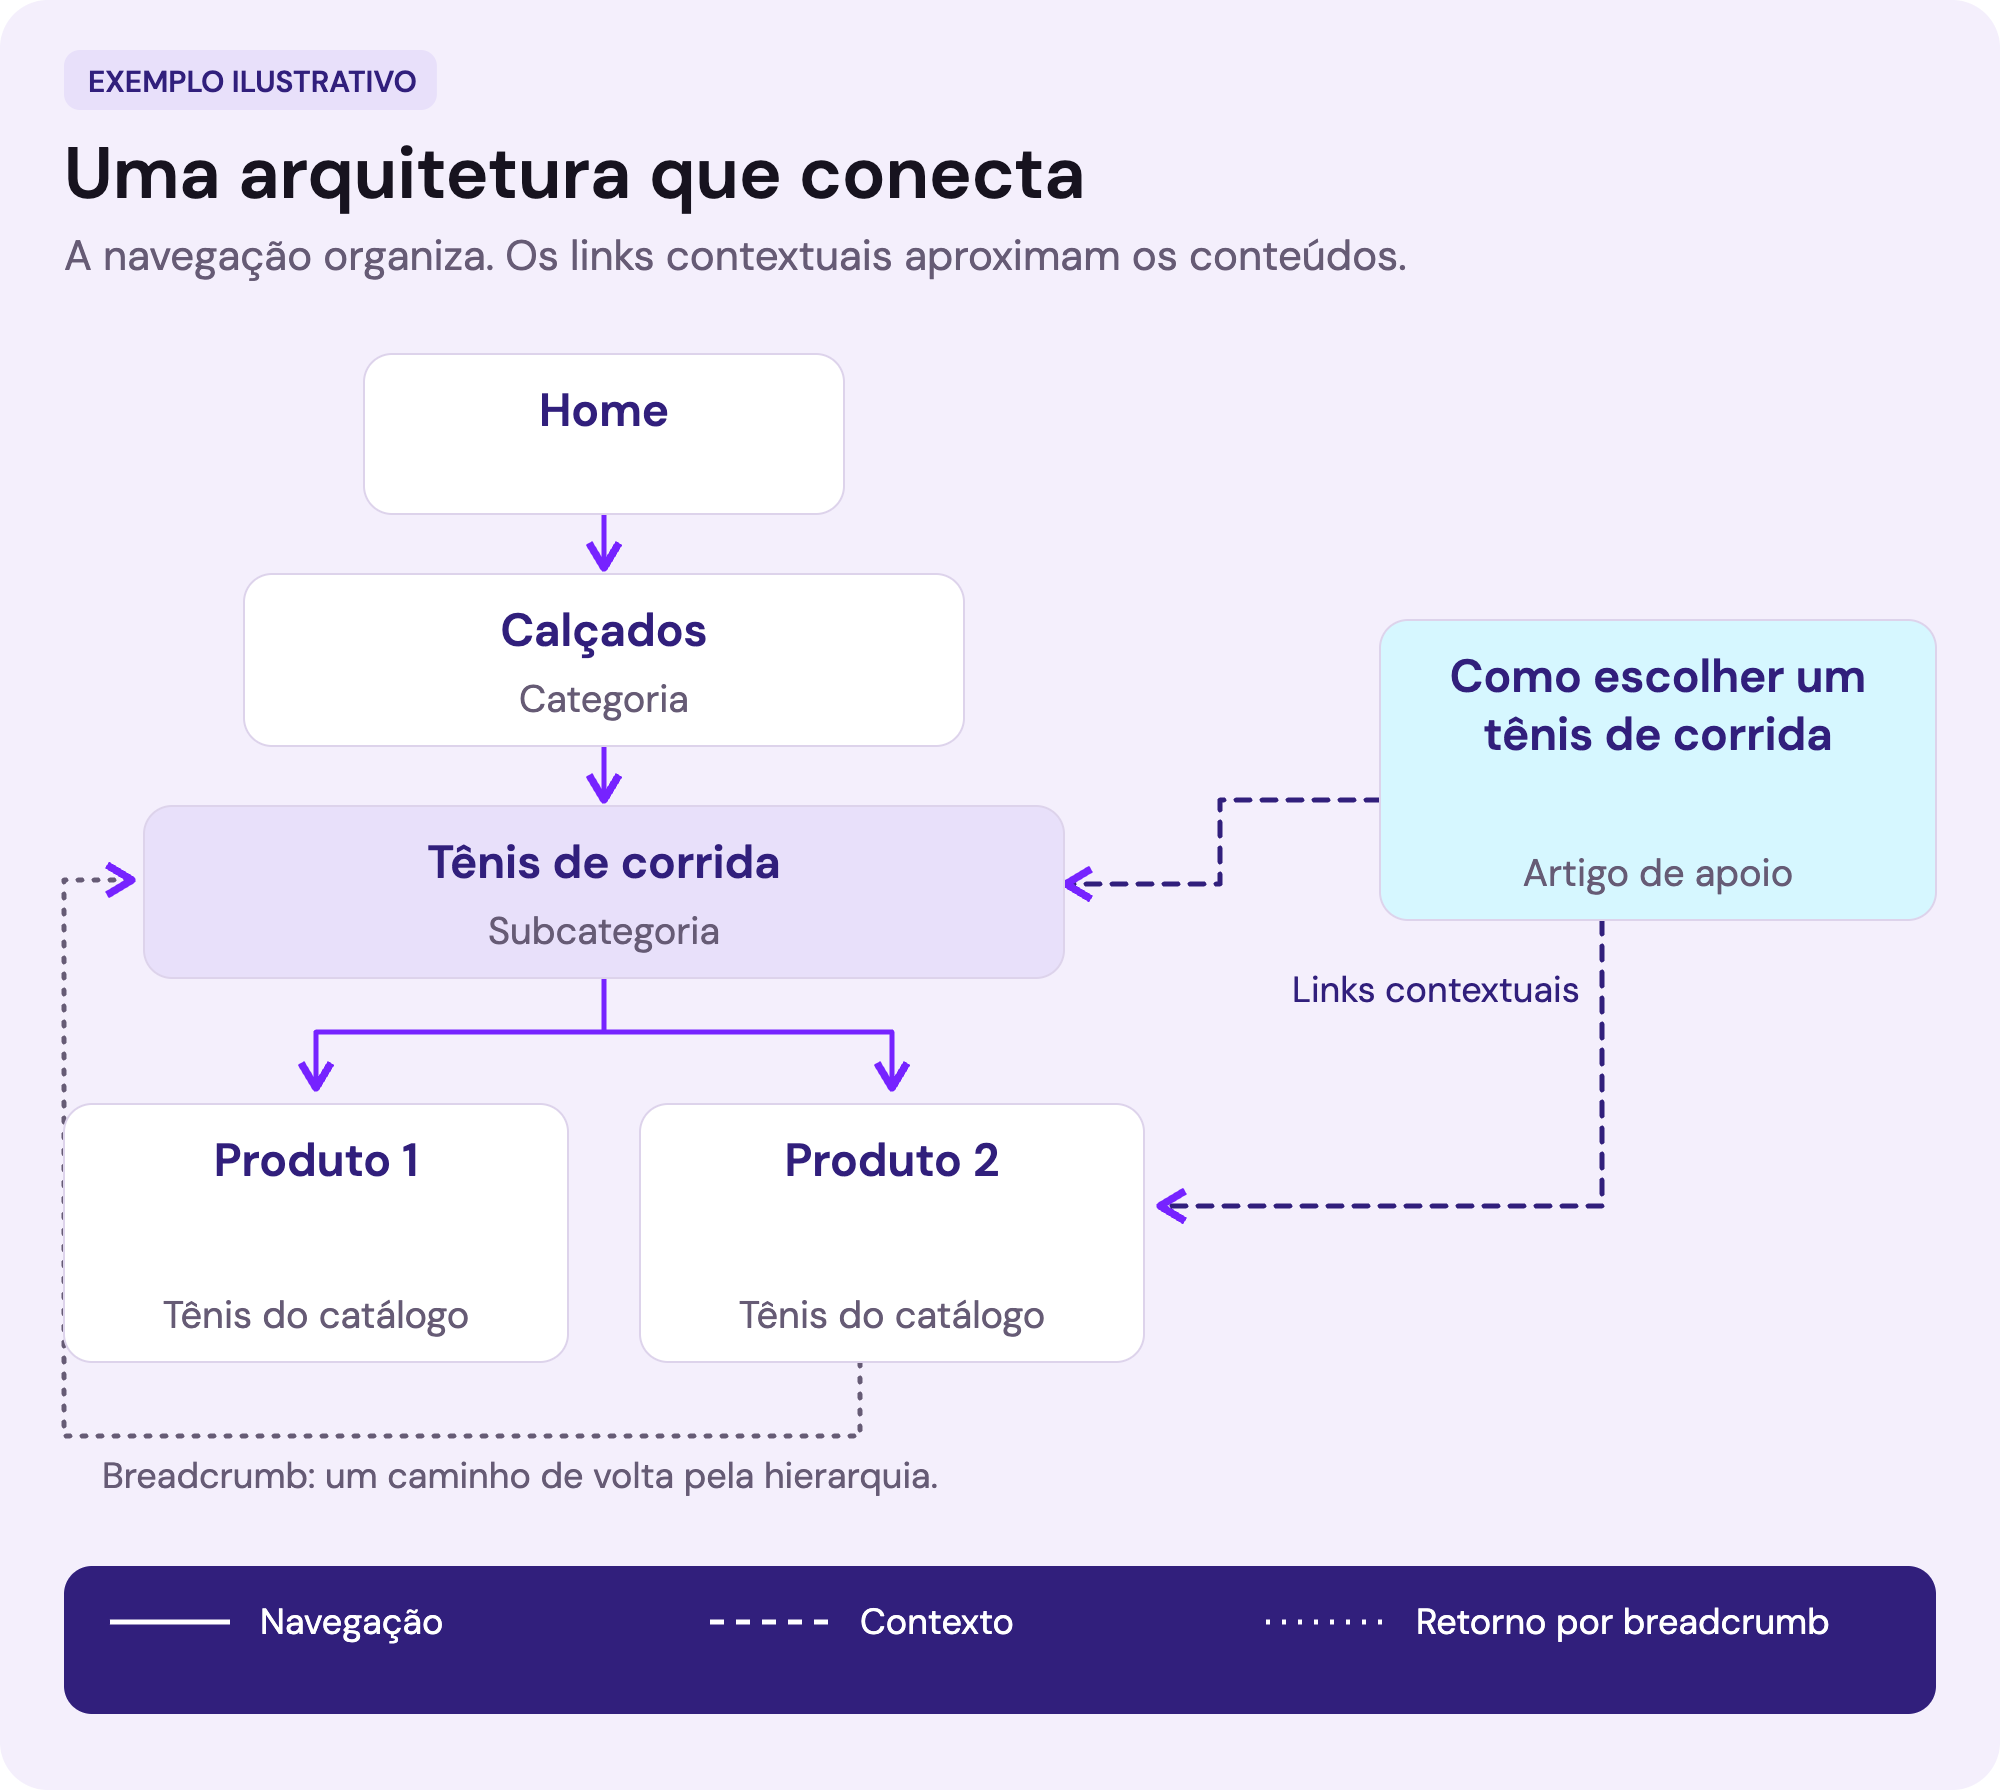
Arquitetura é a forma como as páginas se organizam e se ligam. É ela que diz ao Google o que é importante no site, por onde o rastreamento flui e qual página responde a qual intenção. Conteúdo bom em arquitetura ruim vira página órfã e autoridade diluída.
Hierarquia e profundidade
A estrutura que funciona é rasa e previsível: home, categorias, subcategorias, páginas finais, com o conteúdo de apoio ligado a elas. A profundidade se mede em cliques a partir da home: página que só se alcança depois de muitos cliques, ou só por paginação, recebe pouca autoridade interna e é rastreada com menos frequência. As páginas que vendem precisam estar a poucos cliques da home e linkadas do menu, do rodapé ou de blocos de destaque, nunca só da busca interna.
Profundidade e origem dos links por tipo de página (referência de trabalho, não regra do Google)
| Tipo de página | Distância da home | De onde recebe links internos |
|---|---|---|
| Categoria ou serviço principal | Um clique | Menu, rodapé e home |
| Subcategoria ou serviço específico | Dois cliques | Categoria, conteúdos de apoio e páginas irmãs |
| Produto, unidade ou página final | Até três cliques | Subcategoria, produtos relacionados e conteúdos de apoio |
| Conteúdo de apoio (blog, guia) | Até três cliques | Página pilar, conteúdos do mesmo tema e a página comercial que ele apoia |
URLs
URL é parte da arquitetura: curta, legível, em minúsculas, com palavras separadas por hífen, com a hierarquia em pastas quando a hierarquia existe (/seo-para-ecommerce/vtex/ ↗) e sem parâmetro, ID ou data que não signifique nada para o leitor. URL estável evita mudanças e processamento desnecessários. Quando a mudança é necessária, um redirecionamento permanente corretamente implementado não causa perda de PageRank; o risco está em destinos inadequados, erros e cadeias longas. Para blog e conteúdo, um subdiretório (/blog/) pode facilitar a organização e a manutenção junto ao site principal. O Google aceita também subdomínios: a escolha depende da operação e da arquitetura, e não justifica uma migração apenas pela expectativa de ganho de autoridade.
Links internos
Os links internos são o mapa que o Google segue e a forma como a autoridade circula dentro do site. Três funções: descoberta (toda página importante tem pelo menos um link de outra página indexada), distribuição (as páginas que mais recebem links externos passam autoridade adiante para as que vendem) e significado (o texto âncora diz ao Google do que trata a página de destino; “clique aqui” não diz nada). Página órfã, sem nenhum link interno, só existe no sitemap e tende a sair do índice.
É aqui que a pilarização e pulverização vira estrutura: a página pilar cobre o tema inteiro, as páginas de apoio respondem às subperguntas e todas se linkam entre si e para a página comercial do tema. Esse desenho atende ao Google, que entende a autoridade tópica pelo conjunto, e às IAs, que desdobram a pergunta em subperguntas e buscam fontes para cada uma. A trilha de navegação (breadcrumb) reforça a hierarquia e, com dados estruturados, aparece no resultado de busca no desktop; no celular, o Google deixou de exibi-la em janeiro de 2025.

Paginação e facetas
Listas longas (categorias, blog, resultados) se dividem em páginas numeradas. Cada página da série é uma URL própria, indexável, com canônica para si mesma, e não para a primeira: a canônica para a página um esconde do Google tudo o que está nas seguintes. O Google confirmou em 2019 que não usa rel=next e rel=prev; o que conta são os links entre as páginas da série. Rolagem infinita e botão “carregar mais” precisam de páginas numeradas por trás, ligadas por links com href: o rastreador não clica em botão. As facetas de e-commerce estão no capítulo “E-commerce e sites grandes”.
↗ Na prática
- Rastreie o site com um rastreador e liste as páginas que vendem por profundidade de clique; o que estiver longe da home ganha link do menu, do rodapé ou de páginas fortes.
- Procure páginas órfãs cruzando o sitemap com o rastreamento: página no sitemap sem link interno precisa de link ou de remoção.
- Padronize o texto âncora dos links internos com o nome do que a página vende, sem repetir a mesma frase exata em todo lugar.
- Troque links internos que apontam para redirecionamentos pelo endereço final.
- Mantenha as URLs estáveis; mudança de URL só com redirecionamento planejado.
Velocidade e Core Web Vitals
Velocidade é a parte do SEO técnico que o usuário sente. O Google a mede com os Core Web Vitals, três métricas de experiência colhidas de usuários reais do Chrome, e diz na documentação que elas são usadas pelos seus sistemas de ranqueamento, sem ser um sinal único nem substituir relevância: entre páginas que respondem igualmente bem à busca, a que oferece melhor experiência pode levar vantagem. Para o negócio, o efeito vem antes do ranqueamento: página que demora perde o clique que já tinha e a conversão de quem ficou.
As três métricas
Core Web Vitals: o que cada métrica mede, o limiar bom e a causa mais comum quando falha
| Métrica | O que mede | Bom | Causa mais comum quando falha |
|---|---|---|---|
| LCP (Largest Contentful Paint) | Tempo até o maior elemento visível carregar | Até 2,5 segundos | Servidor lento, imagem de destaque pesada, CSS e fontes bloqueando a renderização |
| INP (Interaction to Next Paint) | Demora da página para reagir a cliques e toques | Até 200 milissegundos | Excesso de JavaScript, scripts de terceiros, tarefas longas na linha de execução principal do navegador (main thread) |
| CLS (Cumulative Layout Shift) | Quanto o layout pula durante o carregamento | Até 0,1 | Imagens, anúncios e banners sem dimensão reservada, fontes trocadas tarde |
O INP substituiu o FID como métrica oficial em 12 de março de 2024. A avaliação é no 75º percentil dos acessos reais, por URL ou grupo de URLs, em celular e em desktop separadamente: não basta a home carregar bem no escritório; três quartos dos acessos de celular à página de produto precisam passar.
Campo e laboratório
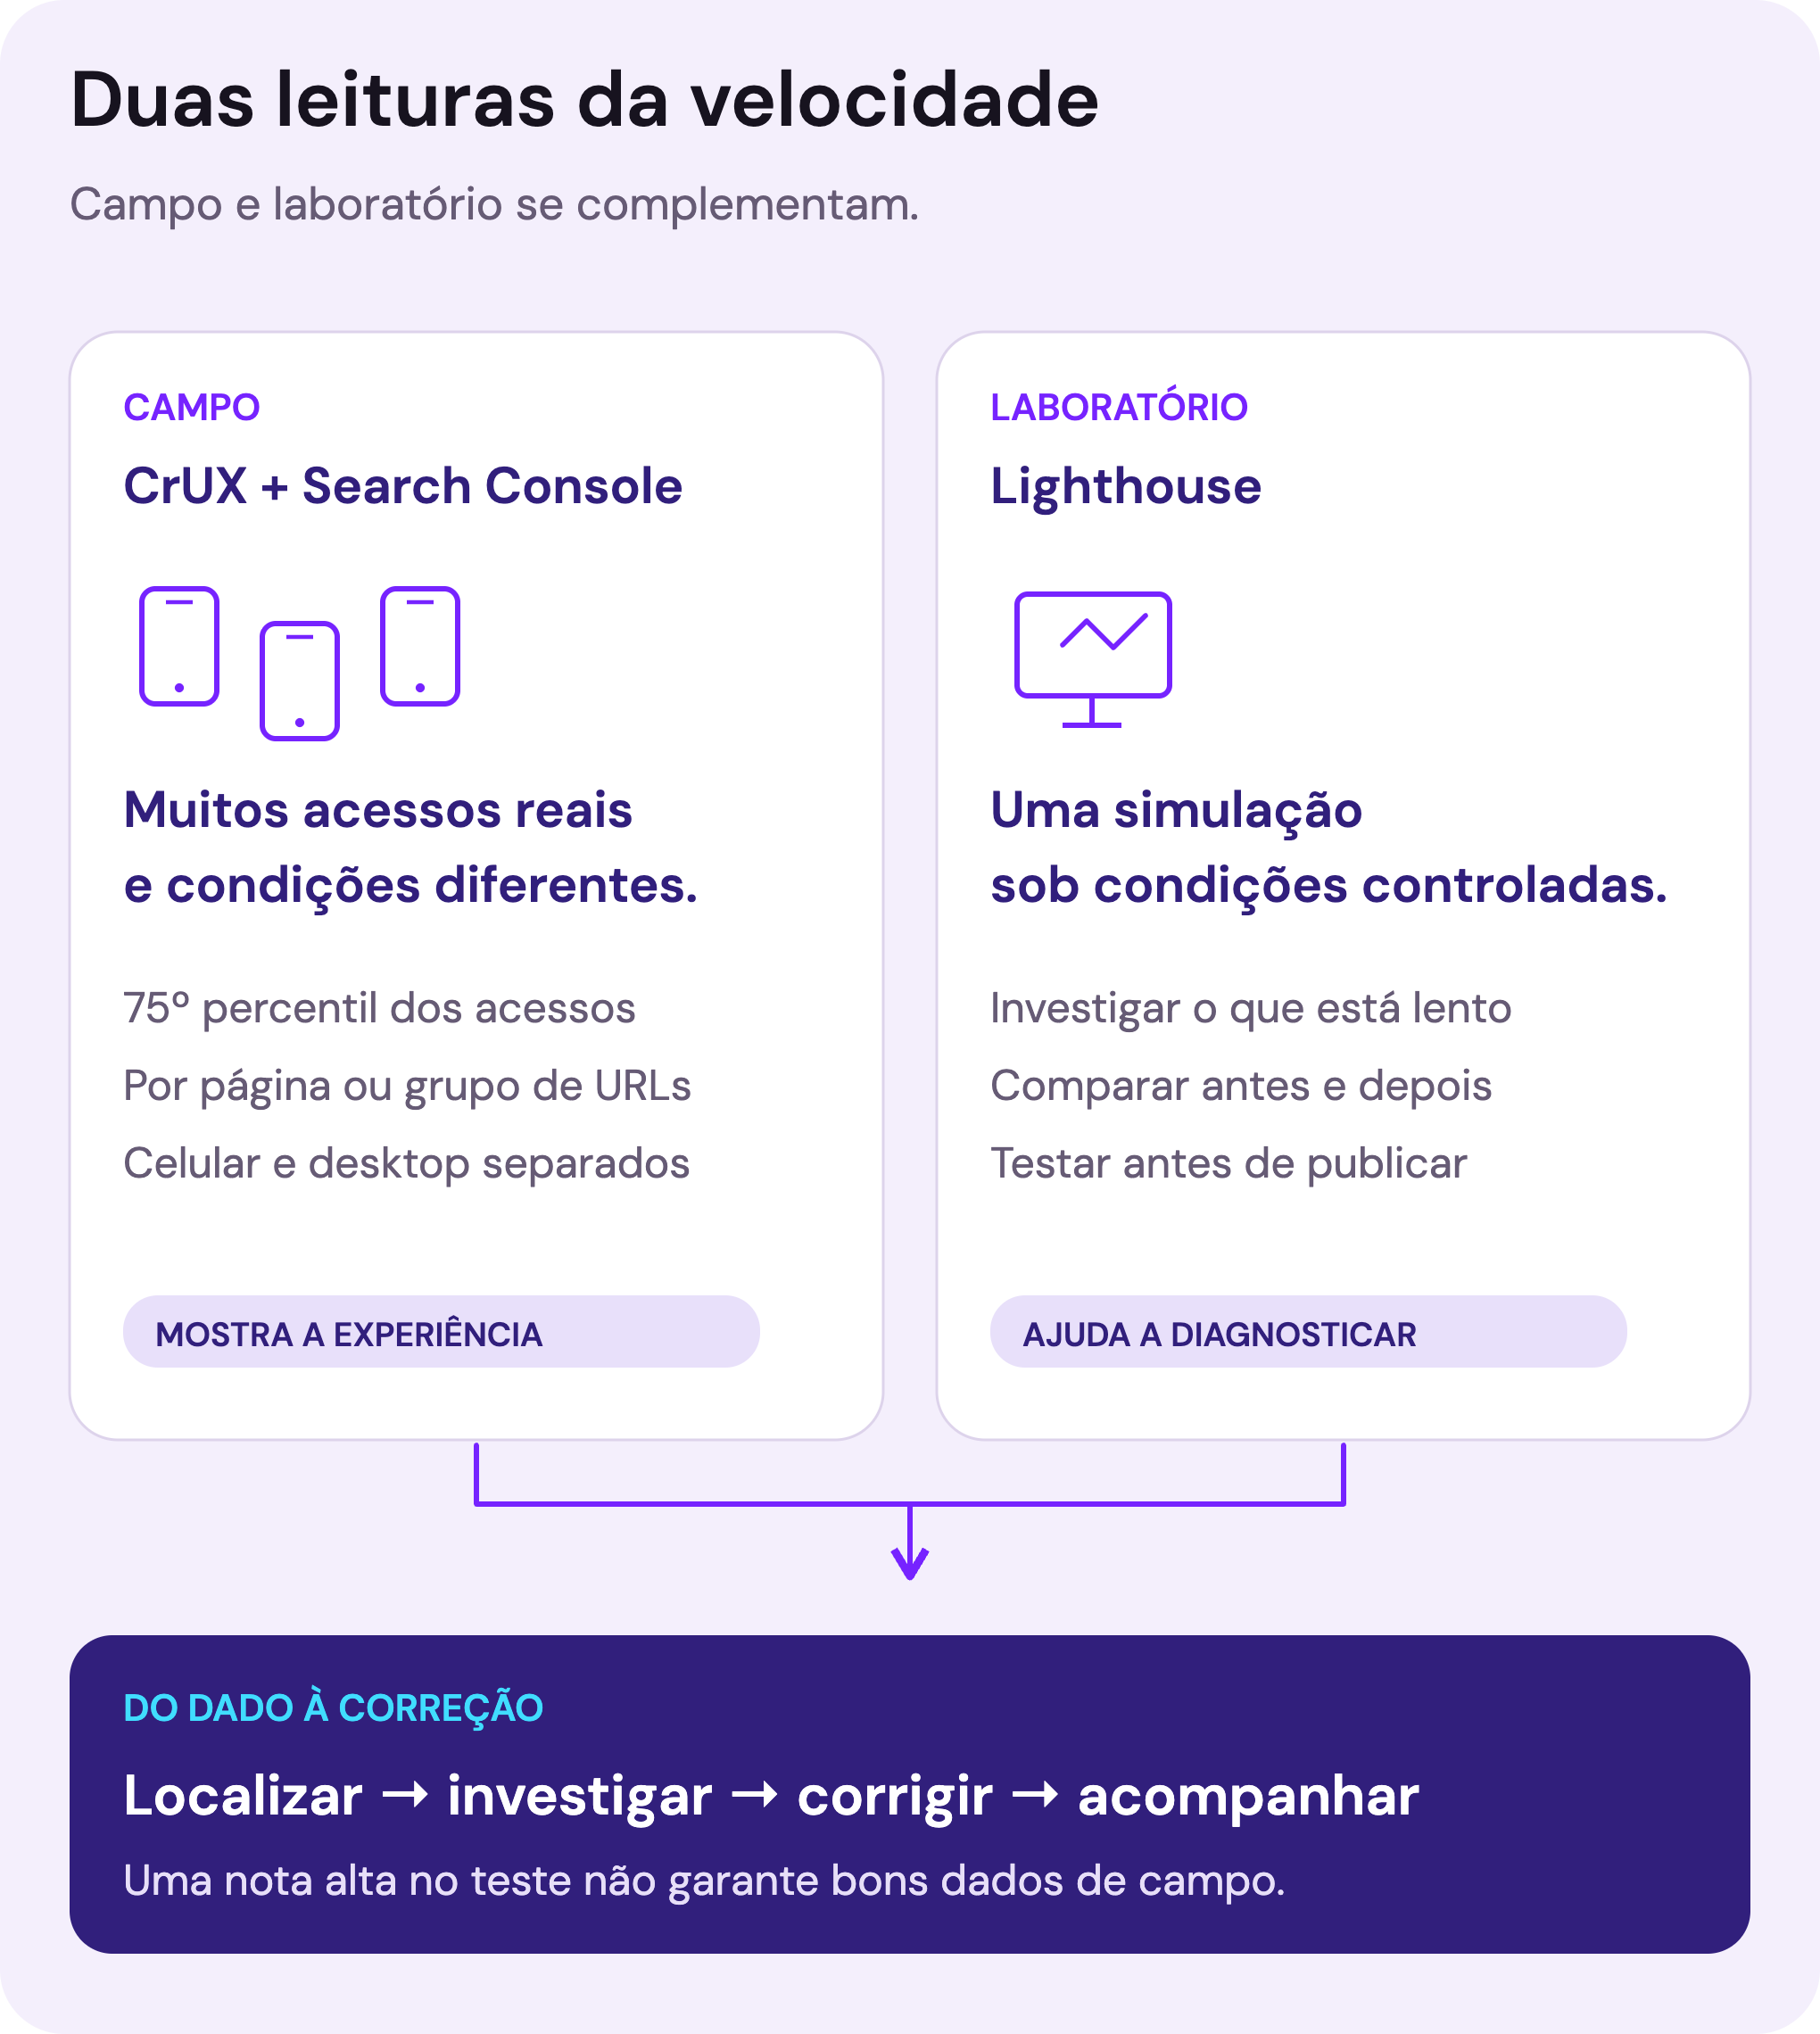
Há dois tipos de medição, e eles divergem. Dados de campo vêm do Chrome User Experience Report (CrUX), a base de usuários reais que alimenta o relatório de Core Web Vitals do Search Console e a parte de cima do PageSpeed Insights; é o que o Google usa. Dados de laboratório vêm de uma simulação (Lighthouse, a parte de baixo do PageSpeed Insights) e servem para diagnosticar e testar antes de publicar, não para declarar vitória. Uma página pode tirar nota alta no laboratório e falhar no campo, porque o usuário real tem rede ruim, celular antigo e scripts de rastreamento que o teste não carrega.

O que costuma resolver
Pela ordem de retorno: tempo de resposta do servidor (cache de página, CDN, banco de dados e plataforma dimensionados), imagens (formato moderno, dimensões declaradas, compressão, carregamento sob demanda só fora da primeira tela), CSS e fontes (o crítico embutido, o resto adiado, fontes com substituta definida), JavaScript (remover o que não é usado, adiar o que não é essencial, auditar tags, chats, pixels e testes A/B carregados pelo gerenciador de tags) e espaço reservado para tudo o que entra depois do carregamento. Em e-commerce, apps e temas são a origem mais frequente do peso; em sites institucionais, construtores de página e vídeo de fundo.
Para rastreadores de IA que não executam JavaScript, métricas de interação como o INP não descrevem a coleta: o acesso depende da resposta do servidor e do conteúdo disponível nela. As plataformas têm comportamentos próprios e nem todas publicam seus limites de espera. Mantenha o tempo de resposta baixo e estável, sem erro em horário de pico, e acompanhe os registros de acesso do servidor, da CDN e do firewall.
↗ Na prática
- Leia primeiro o relatório de Core Web Vitals do Search Console, por grupo de URL, e só depois o PageSpeed Insights: o campo diz onde dói, o laboratório diz por quê.
- Priorize os modelos de página que vendem (produto, categoria, serviço), não a home.
- Faça um inventário dos scripts de terceiros carregados pelo gerenciador de tags e retire o que ninguém usa há meses.
- Defina um orçamento de peso por modelo de página e bloqueie publicações que o estourem.
Dados estruturados
Dados estruturados são a descrição da página em formato que a máquina lê sem ambiguidade: um bloco de código, no vocabulário do Schema.org e no formato JSON-LD que o Google recomenda, dizendo que a página é um produto com tal oferta, um artigo de tal autor, uma empresa com tal endereço. O texto visível continua sendo o que o Google avalia; a marcação diz o que o texto é.
Duas funções, e uma delas encolheu
A primeira função é o resultado rico: estrelas, valor, disponibilidade e autor exibidos junto do resultado. Essa função vem encolhendo por decisão do Google. Em novembro de 2024 saiu a caixa de busca de sitelinks. Em junho de 2025 o Google anunciou a retirada de sete tipos e, em setembro, retirou cinco (informações de curso, salário estimado, vídeo educativo, anúncio especial e listagem de veículos); ações de livro continuaram, e o ClaimReview está em retirada. Em janeiro de 2026 saiu o de exercícios (practice problem), e desde 7 de maio de 2026 o resultado rico de perguntas frequentes (FAQ), restrito a sites de governo e saúde desde 2023, não aparece mais.
Marcações: o que ainda gera resultado rico e o que só descreve a página (Google, outubro de 2026)
| Marcação | Resultado rico hoje | Para que serve além disso |
|---|---|---|
| Product (com Offer e avaliações) | Sim: valor, disponibilidade e estrelas no resultado e nas listagens de produto | Descreve o produto e as variações para o Google |
| Article | Sim, em notícias e artigos | Liga o texto ao autor e à data de publicação e de atualização |
| BreadcrumbList | Sim, só no desktop desde janeiro de 2025 | Reforça a hierarquia do site |
| Organization e LocalBusiness | Sim: logo, dados da empresa e do local | Descreve a entidade e lista os perfis oficiais (sameAs) |
| Event, JobPosting e VideoObject | Sim, nas experiências de evento, vaga e vídeo | Descreve data, local, vaga e vídeo |
| FAQPage | Não, desde 7 de maio de 2026 | Descreve a estrutura de perguntas e respostas, sem destaque na busca |
A segunda função cresceu: a marcação é a forma mais limpa de descrever a entidade (a empresa, o produto, o autor) para o Knowledge Graph (a base de entidades do Google) e para as IAs. Organization com nome, logo, endereço, contato e sameAs (a lista dos perfis oficiais no LinkedIn, no Perfil da Empresa no Google e na Wikipedia, quando existe) diz ao Google quem é a empresa; Article com autor ligado a uma página de autor (author.url e sameAs) ajuda o Google a identificar quem escreveu, parte do que sustenta o E-E-A-T; Product com ofertas e avaliações alimenta as listagens de produto do Google. O Google afirma que não há marcação especial para os AI Overviews e o AI Mode: não é preciso criar arquivos, textos para IA nem schema adicional. O que ajuda é a entidade consistente, com os mesmos dados no site, na marcação e fora dele.
Regras que evitam penalidade
A marcação descreve o que está visível na página, nada além: avaliação marcada sem avaliação exibida, Product numa página de categoria e perguntas marcadas que não aparecem no texto são motivo de ação manual ou de perda do resultado rico. Validação em duas ferramentas: o teste de resultados ricos do Google, que diz o que ele reconhece, e o validador do Schema.org, que diz se o código está correto. O Search Console tem relatórios por tipo de marcação, com erros e avisos; erro bloqueia o recurso, aviso não.
Em plataformas de e-commerce e CMS, a marcação costuma vir do tema ou de um app, e vem errada com frequência: oferta sem moeda, disponibilidade fixa em “em estoque”, dois blocos de Product na mesma página. Por isso a marcação precisa ser auditada a cada troca de tema, app ou plataforma, e não só no lançamento do site.
↗ Na prática
- Publique Organization na home com sameAs para todos os perfis oficiais, e a mesma descrição da empresa em cada um deles.
- Use Product com os campos exigidos para a experiência de produto desejada. Mantenha oferta e disponibilidade coerentes com o que a página mostra; inclua avaliações somente quando forem reais e estiverem visíveis. A ausência de avaliações não impede, por si só, uma marcação de produto válida.
- Ligue Article a uma página de autor real, com nome, cargo e perfis.
- Acompanhe os relatórios de marcação do Search Console a cada troca de tema ou app.
HTTPS, 301 e 404
Este capítulo trata do que o servidor responde antes de qualquer conteúdo: se a conexão é segura, se a URL existe, se mudou de lugar ou se saiu do ar. São respostas de poucos bytes que decidem o destino de páginas inteiras, e as mais fáceis de errar numa troca de servidor, de plataforma ou de regra de CDN.
HTTPS
O Google usa HTTPS como sinal de ranqueamento desde 2014 e o Chrome marca páginas HTTP como “não seguro” desde julho de 2018. Em outubro de 2025, o Google anunciou que o Chrome passaria a ativar por padrão o “Sempre usar conexões seguras”, que pede confirmação antes de abrir sites públicos em HTTP, a partir da versão 154. Site sem certificado válido não é mais opção. O que ainda dá errado é a execução: certificado vencido, que derruba o site inteiro para usuários e rastreadores até a renovação; conteúdo misto (imagem ou script em HTTP dentro de página HTTPS), que o navegador bloqueia; e as quatro versões do mesmo site (HTTP e HTTPS, com e sem www) respondendo em paralelo, cada uma como site próprio. A regra: uma versão canônica, as outras três redirecionando para ela em um salto, certificado com renovação automática e HSTS ativado.
Os códigos de resposta que importam
Códigos de resposta e o que cada um diz ao Google
| Código | O que diz ao Google | Quando usar |
|---|---|---|
| 301 e 308 | A página mudou de endereço em definitivo; o destino vira a canônica e herda os sinais | Troca de URL, de domínio ou de protocolo; fusão de páginas |
| 302 e 307 | A mudança é temporária; a URL original segue no índice | Promoção ou teste temporário |
| 304 | Nada mudou desde a última visita; o Google mantém a versão que já tem | Resposta a requisições condicionais: o servidor precisa suportar ETag ou Last-Modified (o Google recomenda ETag) |
| 404 | A página não existe | Conteúdo removido sem substituto |
| 410 | A página foi removida de propósito | Remoção definitiva; para o Google, tem o mesmo efeito do 404 |
| 429 e 5xx | O servidor está sobrecarregado ou com erro; o rastreador desacelera | Nunca de propósito, a não ser para reduzir o rastreamento por um a dois dias, no máximo (503 ou 429, com o cabeçalho Retry-After), ou na página de verificação de robô da CDN (503) |
Redirecionamentos
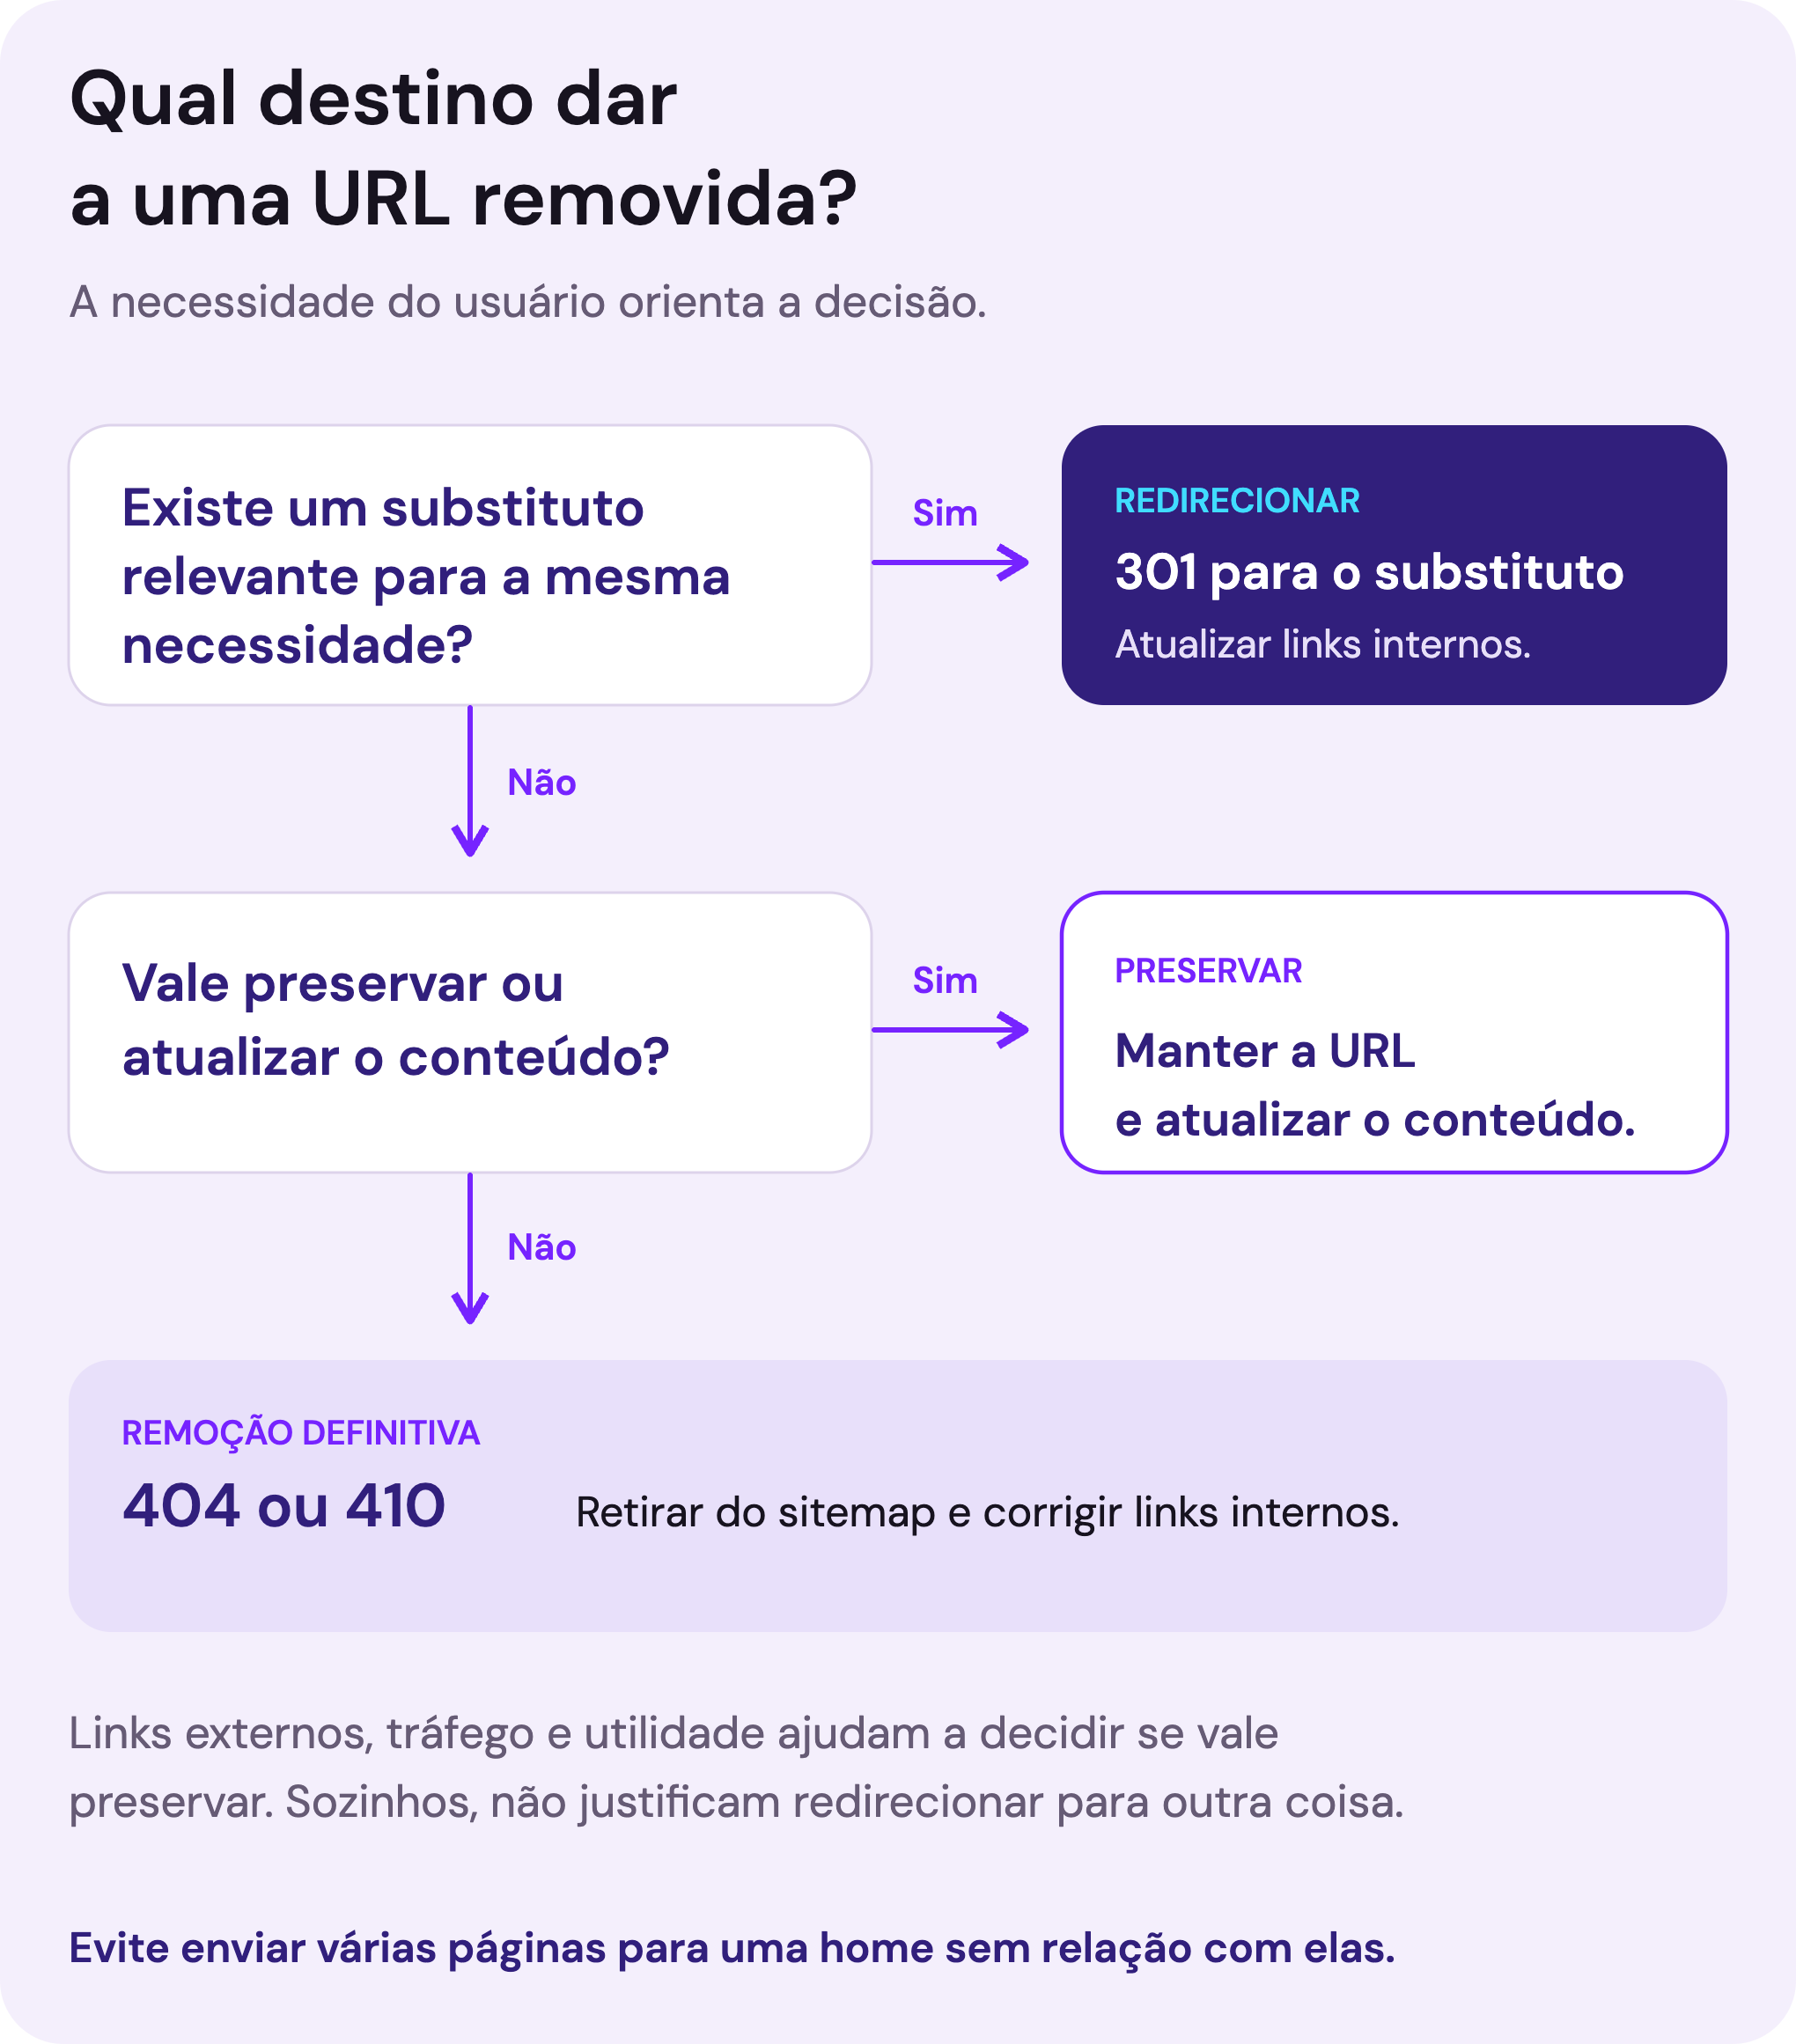
Redirecionamento certo é 301 (ou 308), de uma URL para um destino relevante que substitua o conteúdo ou atenda à mesma necessidade, preferencialmente em um salto. Redirecionamentos permanentes corretamente implementados não causam perda de PageRank. Cadeias (A para B para C) acrescentam latência e trabalho de rastreamento; loops impedem chegar ao destino. O Google segue um número limitado de saltos antes de desistir, e o Search Console pode acusar “erro de redirecionamento”. Mandar muitas URLs antigas para uma home sem relação com o conteúdo pode gerar soft 404, sem consolidar os sinais como se espera. Redirecionamento por meta refresh ou JavaScript fica como alternativa quando não é possível usar o servidor. O Google recomenda manter os redirecionamentos por pelo menos um ano, e vale mantê-los enquanto a URL antiga receber links ou visitas.
Páginas de erro
Uma página que não existe precisa responder 404 (ou 410) de verdade. O soft 404, página que diz “não encontrado” ou vem vazia enquanto o servidor responde como se tudo estivesse bem, é o erro mais comum em e-commerce: produto esgotado que vira página em branco, busca sem resultado indexada, categoria removida que continua respondendo. O Google rastreia essas páginas repetidas vezes e gasta nelas o orçamento que faltará às páginas que vendem. A página 404 útil (com busca, links para categorias e para a home) ajuda o usuário; o que importa para o índice é o código.
O destino precisa responder à necessidade atendida pela página antiga. Quando há substituto relevante, use redirecionamento permanente. Sem substituto, avalie se vale preservar ou atualizar o conteúdo, especialmente quando há links externos, tráfego ou posição. Se a remoção for definitiva, responda 404 ou 410 e retire a URL do sitemap e dos links internos. Ter backlinks, sozinho, não justifica redirecionar para uma página que não atende à mesma necessidade. Os rastreadores de IA também encontram URLs quebradas: no estudo da Vercel de dezembro de 2024, os da OpenAI e da Anthropic gastavam mais de um terço das requisições em páginas 404.

↗ Na prática
- Confira as quatro versões do domínio (HTTP, HTTPS, com e sem www) e as barras finais: todas redirecionam em um salto para a canônica.
- Exporte os redirecionamentos do servidor e procure cadeias, loops e destinos que também redirecionam.
- Liste no Search Console os soft 404 e os 404 com links internos; os primeiros ganham o código certo, os segundos perdem o link.
- Ative a renovação automática do certificado e um alerta de vencimento.
Sites em mais de um idioma ou país
Quando a empresa vende em mais de um país ou atende em mais de um idioma, o site precisa dizer ao Google qual versão mostrar para cada pessoa. Sem isso, a versão em espanhol aparece para o comprador brasileiro, a versão de Portugal disputa com a do Brasil e as duas se canibalizam.
Quando a empresa precisa disso
O hreflang e a estrutura por país entram quando há mais de uma versão da mesma página: em idiomas diferentes (português, espanhol, inglês) ou no mesmo idioma para países diferentes (Brasil e Portugal, com termos, moeda e regras próprios). Site só em português, que atende só o Brasil, não precisa de hreflang. Tradução automática sem revisão também não resolve: a versão de cada país precisa responder às buscas daquele mercado, com os termos que o cliente local usa, a moeda, os meios de pagamento e as condições de entrega. Sem hreflang, as versões de Brasil e Portugal podem disputar a mesma busca, e o comprador de um país cai na página do outro, com valor na moeda errada e frete que não atende.
Domínio por país, subdomínio ou subdiretório
Há três estruturas que funcionam e uma que o Google não recomenda. A escolha é de negócio antes de ser técnica: quantos países, quanto conteúdo próprio em cada um e quanta autoridade o domínio principal já tem.
Domínio por país, subdomínio ou subdiretório (Google, gestão de sites multirregionais)
| Estrutura | Exemplo | A favor | Contra |
|---|---|---|---|
| Domínio por país | empresa.com.ar | Sinal claro de país; sites separados | Mais custo e infraestrutura; cada domínio constrói autoridade do zero |
| Subdomínio | ar.empresa.com | Fácil de montar; servidores em locais diferentes | O usuário nem sempre reconhece o país pela URL |
| Subdiretório | empresa.com/ar/ | Fácil de montar e de manter; soma autoridade ao domínio que já existe | Um só servidor; separar os sites depois é mais difícil |
| Parâmetro na URL | empresa.com?pais=ar | Não recomendado pelo Google | Segmentação difícil e pouco clara para o usuário |
Para a maioria das empresas brasileiras que começam a vender fora, o subdiretório é o caminho de menor custo, porque a autoridade construída no Brasil soma para as versões novas.
Hreflang
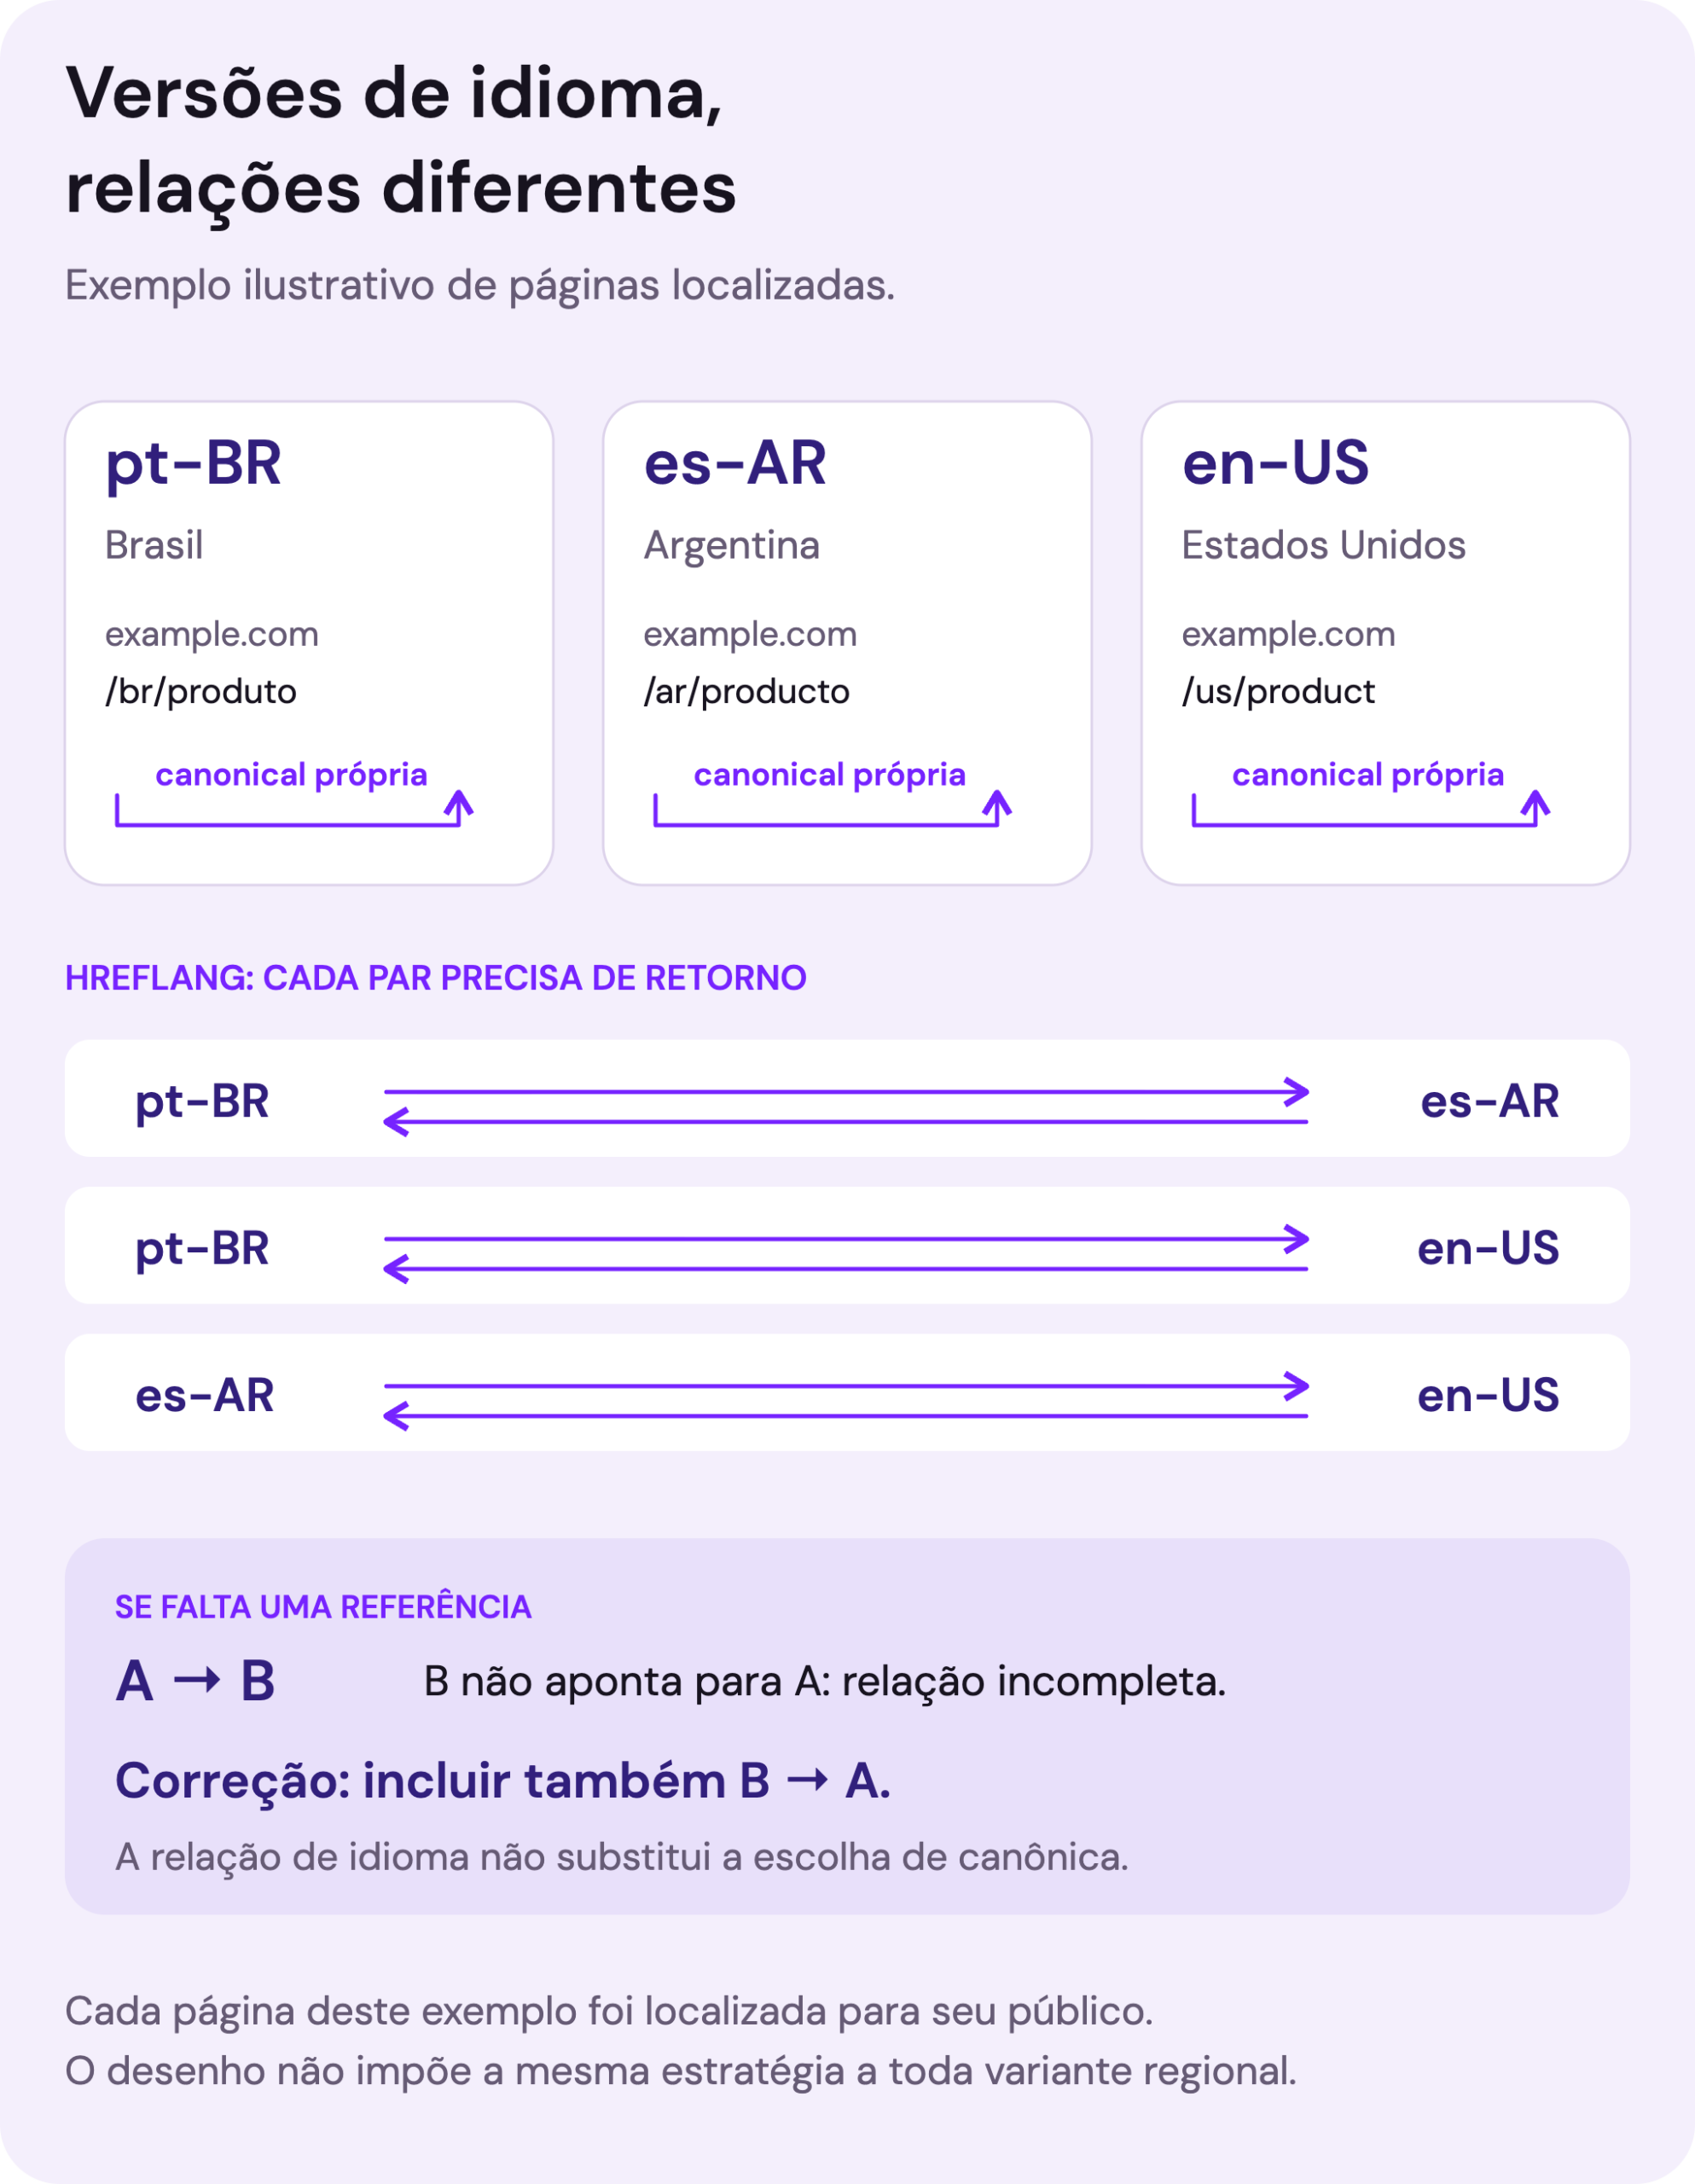
O hreflang é a marcação que diz ao Google quais páginas são versões umas das outras e para qual idioma e país cada uma serve. Ele pode ir no HTML, no cabeçalho HTTP ou no sitemap; para o Google, os três caminhos são equivalentes. As regras que mais pegam: cada versão lista a si mesma e todas as outras; se duas páginas não apontam uma para a outra, o Google ignora as marcações; o idioma segue o padrão ISO 639-1 e o país, o ISO 3166-1 (pt-BR, es-MX, en-US); o valor x-default indica a página para quem não se encaixa em nenhuma versão. A canônica de cada versão aponta para ela mesma, nunca para a versão de outro idioma. O Google não usa o hreflang nem o atributo lang para detectar o idioma de uma página: ele lê o conteúdo.
O Google também pede para não redirecionar automaticamente o visitante para outra versão a partir do idioma do navegador ou do país presumido: o Googlebot costuma rastrear a partir dos EUA, sem informar idioma, e o redirecionamento automático pode esconder dele as outras versões. A alternativa é um aviso com links para as versões, que o visitante escolhe.

↗ Na prática
- Decida a estrutura pelo plano de expansão: país com operação e conteúdo próprios pede mais do que tradução.
- Gere o hreflang de uma tabela única, com retorno e autorreferência em todas as versões, e inclua o x-default.
- Troque o redirecionamento automático por idioma por um aviso com links para as versões.
- Confira no Search Console, por país, se cada versão recebe impressões do mercado certo.
Migração sem perder posições
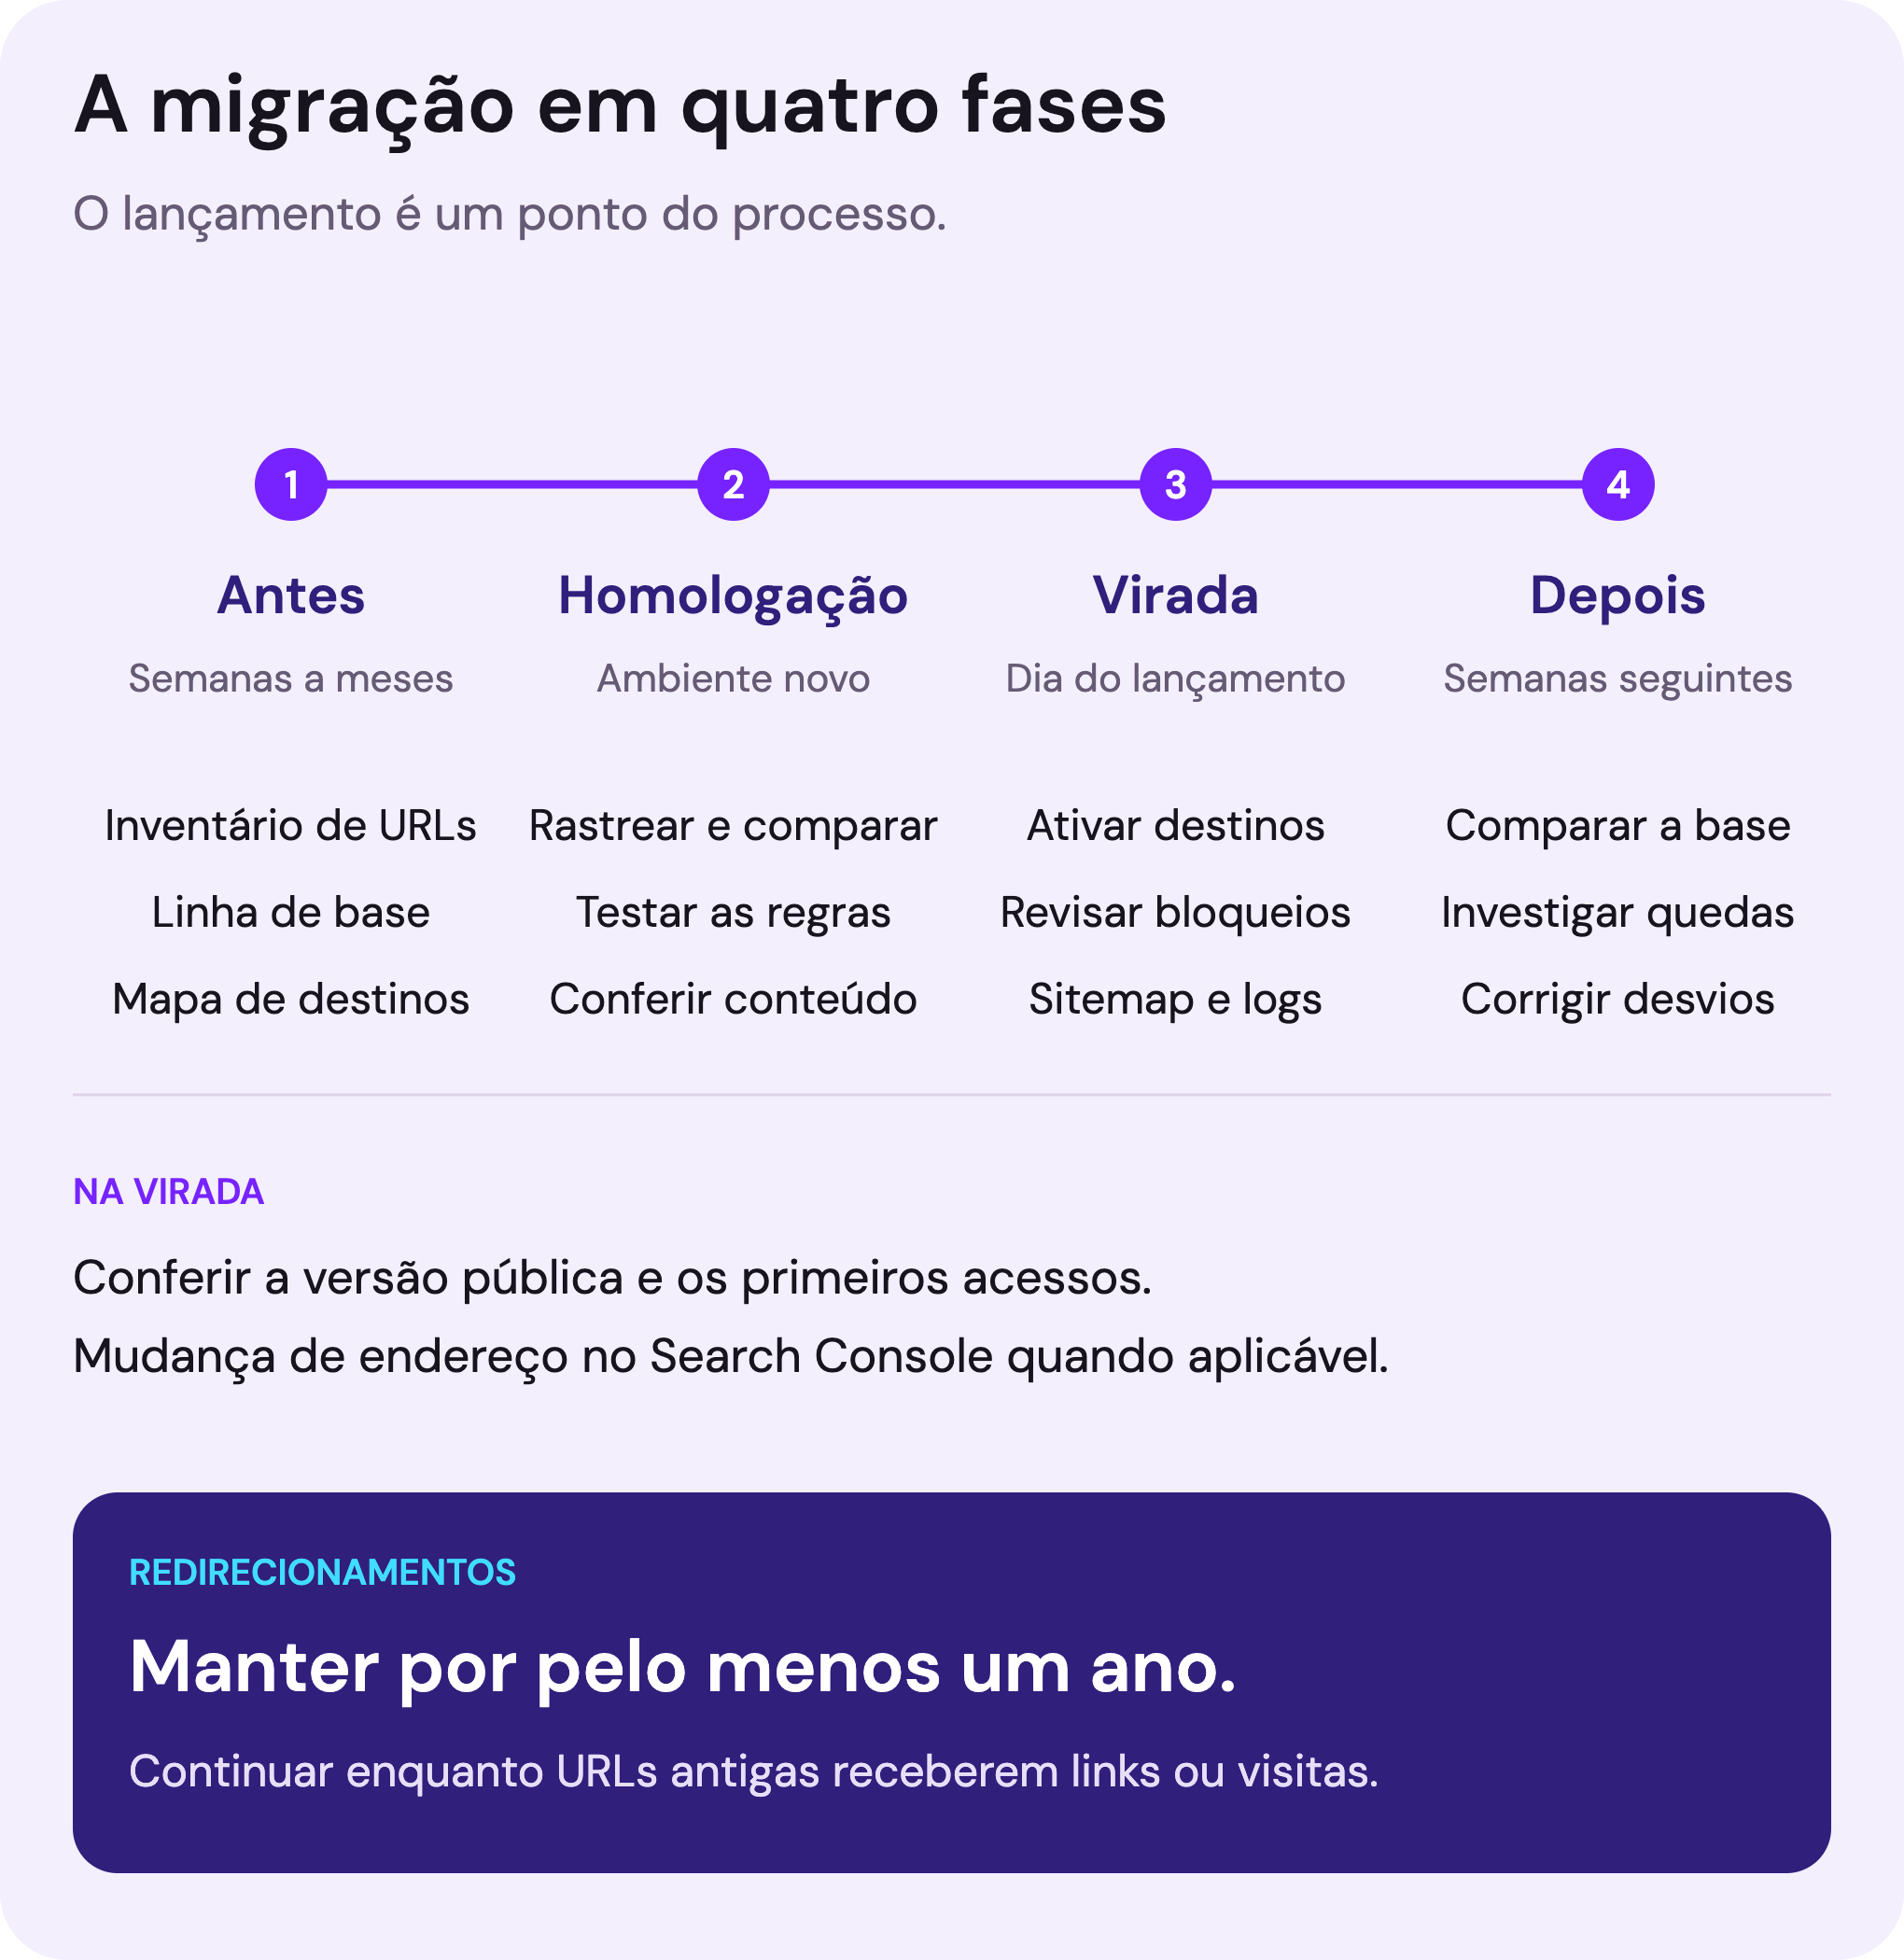
Migração é qualquer mudança que faça o Google reaprender o site de uma vez: troca de plataforma, de domínio ou de marca, redesign com troca de tema, reestruturação de categorias e URLs. A meta de uma migração é não perder; o ganho vem da arquitetura nova, depois. Quando dá errado, a perda costuma ter duas origens: redirecionamentos que faltam ou erram, e conteúdo que ranqueava e não entrou no projeto.

Antes: inventário, mapa e linha de base
O trabalho começa meses antes do lançamento, com o SEO na mesa de arquitetura. Inventário de tudo o que existe: URLs do sitemap, do log do servidor, do Search Console, do GA4 e dos backlinks, porque o que ranqueia hoje nem sempre está no CMS (filtros, páginas antigas, produtos descontinuados com tráfego). Linha de base registrada: posições, cliques e impressões por página, tráfego e receita orgânica por tipo de página, páginas indexadas. Mapa de redirecionamentos URL a URL, da antiga para a equivalente nova, com regra para o que não tem equivalente (404 ou 410, nunca a home). E uma mudança por vez sempre que possível: trocar domínio, plataforma, conteúdo e design no mesmo dia impede saber o que causou uma queda.
Durante: homologação com checklist
O ambiente de homologação fica fechado para o índice (por senha, não por robots.txt, que não impede a URL de ser descoberta) e aberto para teste. O checklist técnico roda nele antes de qualquer data.
O checklist da homologação
| Item | O que conferir | Como saber que está certo |
|---|---|---|
| Redirecionamentos | Amostra das URLs mais importantes e o mapa inteiro, em massa | Cada URL antiga chega à nova equivalente em um salto |
| Metadados e marcação | Canônicas, títulos, metas, headings e dados estruturados | Iguais ou melhores que os do site atual, página a página nos modelos principais |
| Links internos | Menu, rodapé, conteúdo e paginação | Apontam para as URLs novas, sem passar por redirecionamento |
| Arquivos de controle | robots.txt e sitemaps novos | Prontos, sem bloqueio de CSS e JavaScript e só com URLs canônicas |
| Conteúdo | Textos de categoria, produto e serviço | Migrados inteiros, inclusive o que estava fora do CMS |
| Rastreamento | O ambiente novo inteiro, com um rastreador | Comparado ao rastreamento do site atual, sem páginas perdidas |
O dia da virada
O lançamento tem ordem: redirecionamentos ativos no mesmo instante em que o site novo sobe; bloqueio da homologação removido e o site novo conferido sem noindex; sitemap novo enviado; mudança de endereço informada no Search Console quando o domínio muda; log acompanhado nas primeiras horas, à procura de 404, 5xx e cadeias. Desde junho de 2026, a ferramenta de mudança de endereço do Search Console vale para todas as variantes verificadas do domínio antigo, com subdomínios e versões com e sem www. Lançar fora do pico de vendas, com o time inteiro disponível, não é detalhe.
Depois: semanas de vigilância
O Google diz que um site pequeno ou médio leva algumas semanas para ter a maior parte das páginas movidas, que sites grandes levam mais e que a visibilidade pode oscilar durante a mudança. Nesse período, a comparação com a linha de base é semanal: posições, indexação por sitemap, erros, tráfego por tipo de página. Os redirecionamentos ficam por pelo menos um ano. O que os modelos de IA aprenderam no treinamento sobre a empresa não muda com a migração, e não há prazo público para que mude: nome, descrição e dados da empresa precisam ser os mesmos antes e depois, no site e nos perfis, para que a busca ao vivo das IAs encontre a mesma entidade.
Em e-commerce, cada plataforma de destino muda a URL do seu jeito; a página SEO para Migração de E-commerce detalha os cinco tipos de migração e a linha do tempo.
↗ Na prática
- Comece pelo inventário de URLs (sitemap, log, Search Console, backlinks) e pela linha de base, antes de qualquer decisão de projeto.
- Exija o mapa de redirecionamentos URL a URL como entregável do projeto, testado em homologação.
- Não lance sem rastrear a homologação de ponta a ponta e comparar com o site atual.
- Revise a linha de base toda semana depois do lançamento, com quem pode corrigir no mesmo dia.
E-commerce e sites grandes
Em site grande, SEO técnico é uma questão de proporção: a plataforma gera mais URLs do que a loja precisa, cada modelo de página se repete milhares de vezes e um erro de modelo de página vira milhares de erros. O trabalho muda de “corrigir páginas” para “definir regras”, e a regra certa numa categoria resolve o catálogo inteiro.
Facetas, filtros e parâmetros
A navegação facetada (cor, tamanho, marca, faixa de valor, ordenação) é a maior fábrica de URLs de um e-commerce. A regra depende do objetivo. Faceta com demanda de busca própria e estoque estável pode virar página indexável, com URL limpa, título, texto e links internos, como uma subcategoria. Para versões duplicadas ou muito semelhantes de uma página, a canonical indica a versão preferida, mas não é uma ordem de exclusão. Quando uma faceta precisa continuar acessível e não deve ser indexada, use noindex com rastreamento permitido. Para poupar rastreamento em ordenações, combinações sem demanda e busca interna, avalie bloqueio no robots.txt ou filtros por fragmento (#), sem esconder caminhos necessários à descoberta dos produtos. Se essas URLs já estão indexadas e precisam sair, primeiro permita que o rastreador processe a instrução de exclusão; robots.txt não garante a retirada. A decisão vem da pesquisa de palavras-chave cruzada com o estoque e é revista a cada ciclo. O Google avisa que canonical e nofollow são menos eficazes, no longo prazo, para limitar rastreamento. Nas facetas que ficam rastreáveis, mantenha a ordem dos filtros, use o separador & padrão e responda 404 para combinações sem produto (Google, navegação facetada, dezembro de 2024).
Quatro objetivos para tratar facetas e parâmetros
| Objetivo | Exemplo | Tratamento | Por quê |
|---|---|---|---|
| Indexar | Tênis de corrida masculino, com busca própria e estoque estável | URL limpa, título, texto, links internos e lugar no sitemap | Responde a uma busca com demanda, como uma subcategoria |
| Consolidar versões | Variações duplicadas ou muito semelhantes à categoria principal | Canonical para a versão preferida, com sinais coerentes | Indica preferência entre versões semelhantes; não garante exclusão |
| Impedir indexação | Faceta útil ao usuário, mas que não deve aparecer na busca | Noindex com rastreamento permitido | O rastreador precisa ler a instrução para excluir a página |
| Limitar rastreamento | Ordenação, combinações sem demanda e busca interna | Robots.txt ou filtro por fragmento (#), conforme o caso | Poupa rastreamento; não garante retirada do índice nem deve esconder os produtos |
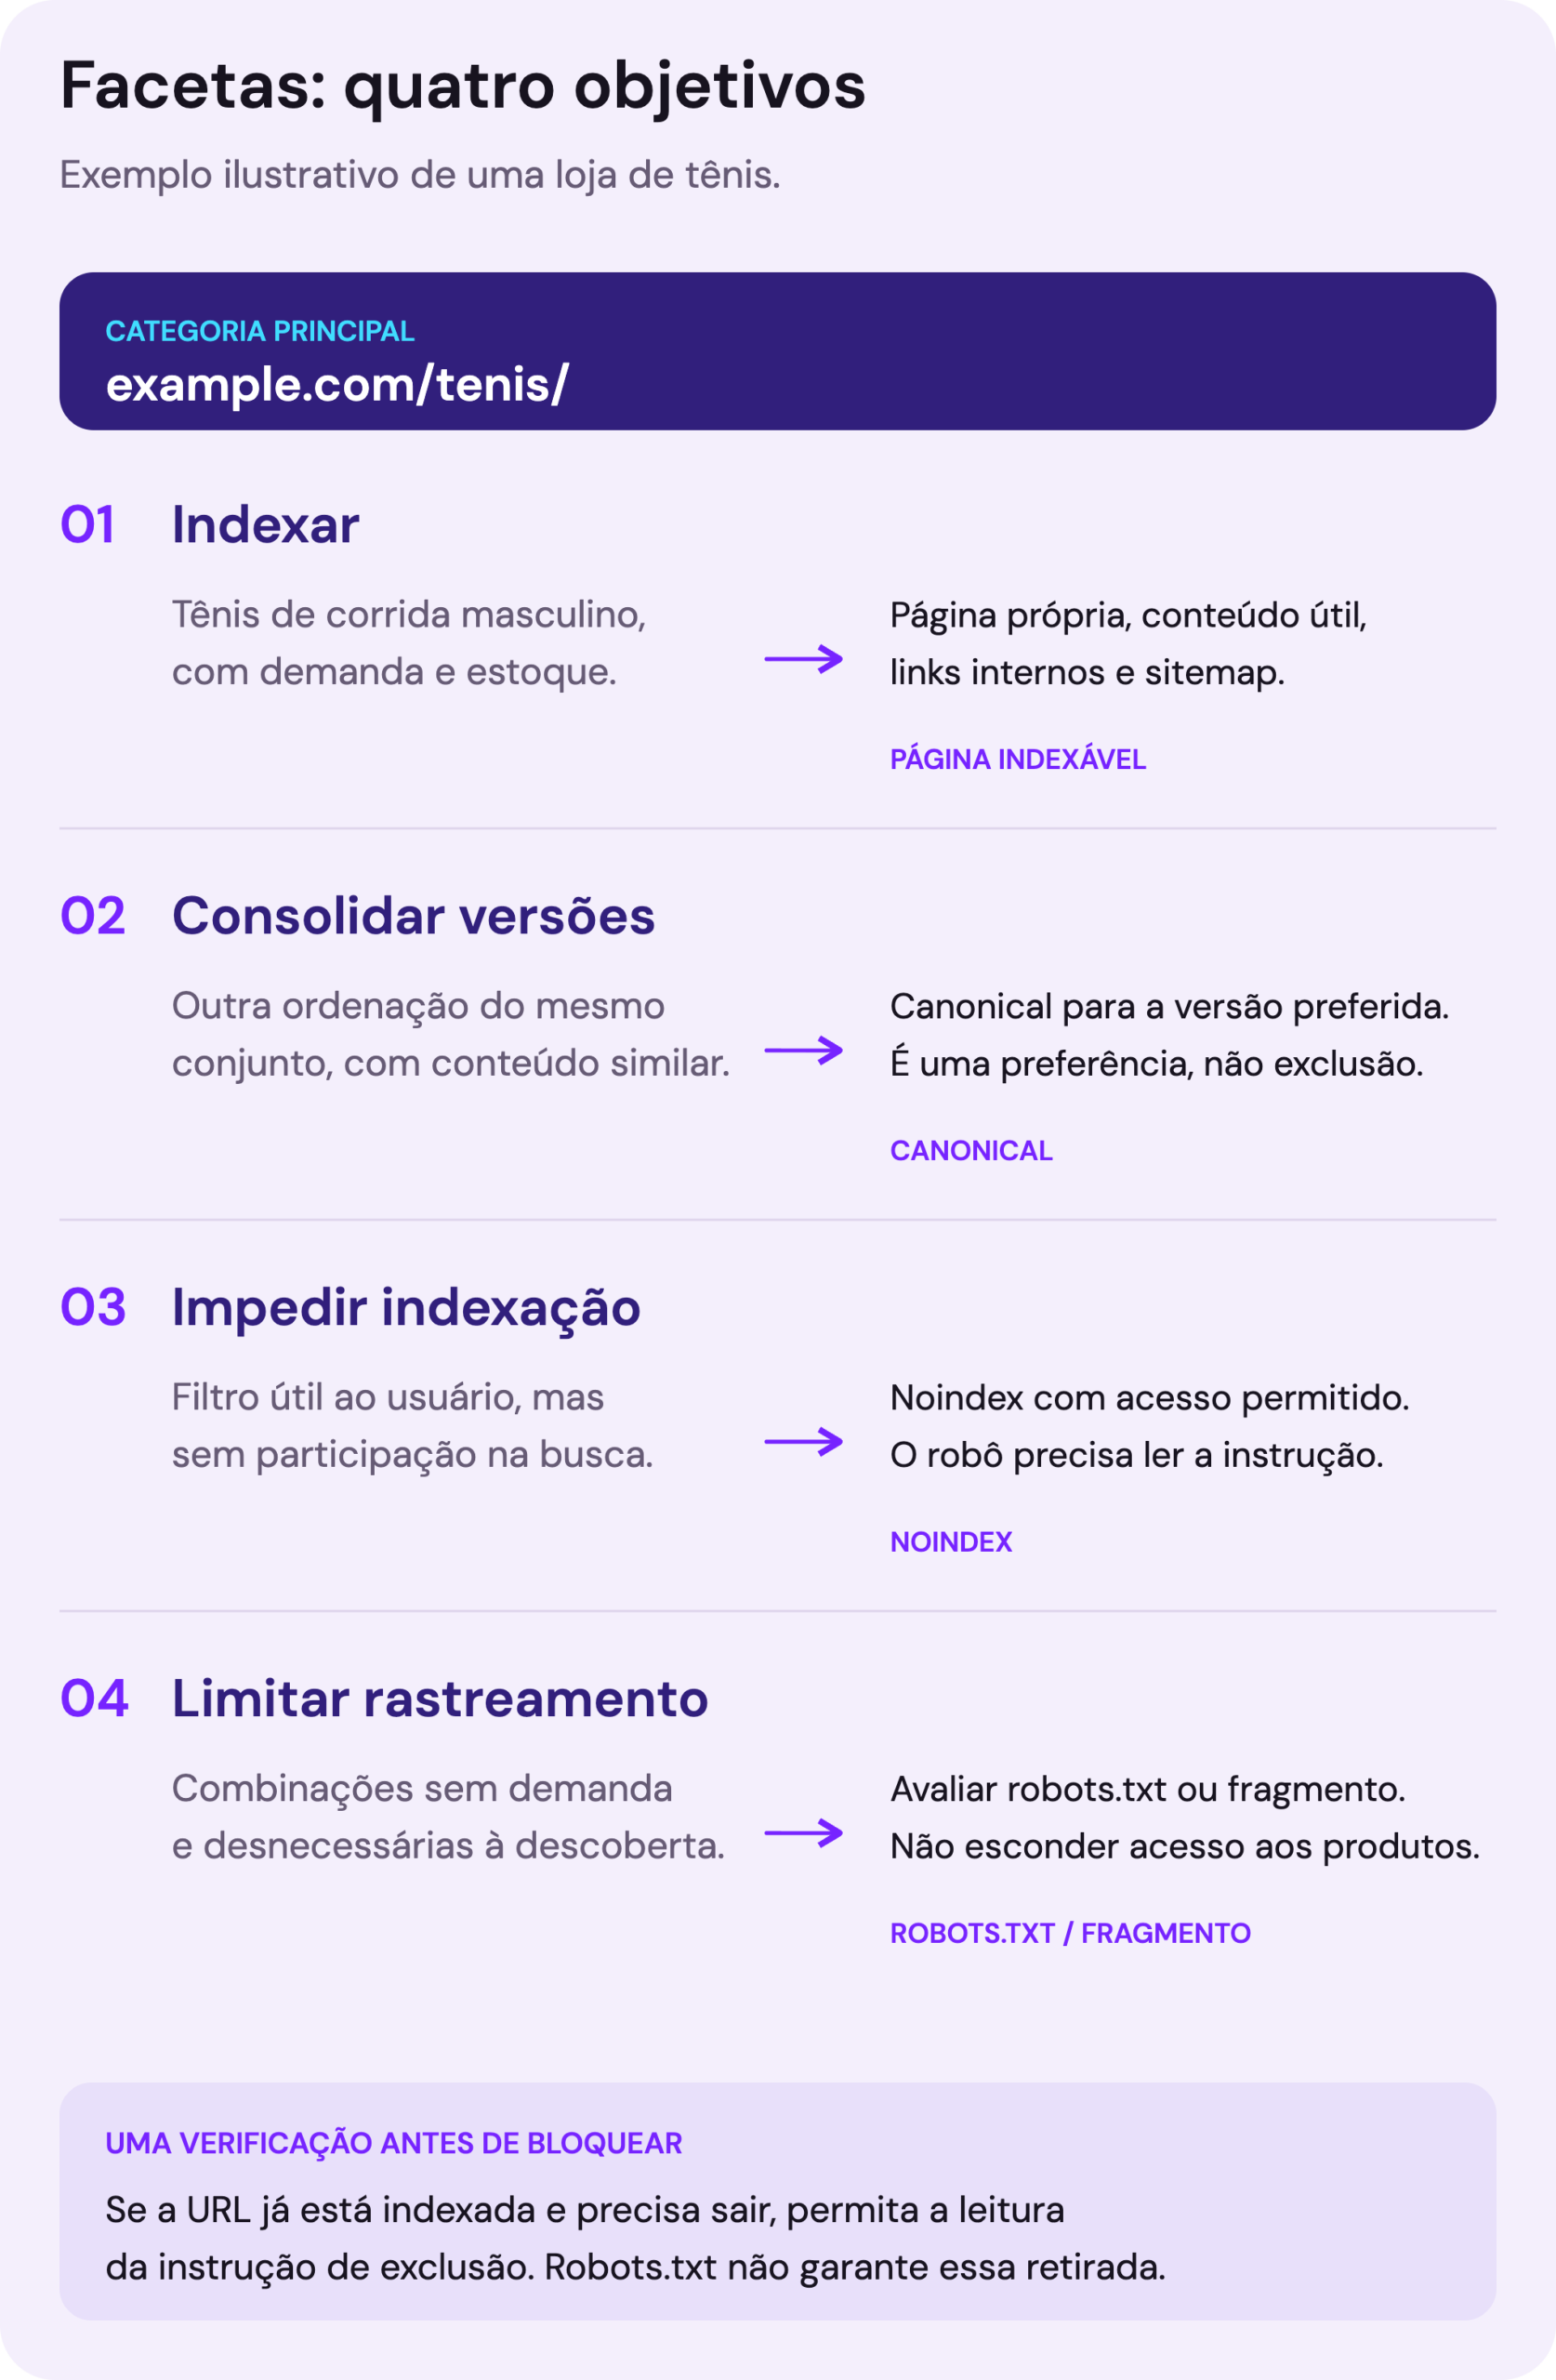

A pesquisa que define quais facetas merecem uma página indexável está no Guia de Palavras-chave e Intenção de Busca.
Produtos, variações e estoque
Um produto, uma URL. Variações de cor e tamanho ficam na mesma página, com a seleção em parâmetro e canônica para o produto principal, a não ser que a variação tenha busca própria e mereça página. O Google documenta os dois desenhos com a marcação ProductGroup (variesBy e hasVariant): página única, com uma canônica para o grupo e cada variação pré-selecionável por parâmetro de URL, ou uma página por variação, cada uma com a marcação completa. Produto esgotado tem três destinos: se volta, a página fica no ar com a informação de reposição e os dados estruturados atualizados; se não volta e tem equivalente, redireciona para ele; se não volta e não tem, responde 404 ou 410. Página de esgotado em branco é soft 404 em escala. Descrições copiadas do fabricante são conteúdo duplicado contra dezenas de lojas; as páginas SEO para VTEX, SEO para Shopify e SEO para Nuvemshop tratam disso por plataforma.
Categoria é o maior ativo
Em e-commerce, a página de categoria é a que mais ranqueia e mais vende pelo orgânico. Precisa de texto próprio, links para as subcategorias e para as facetas indexáveis, paginação com canônica própria em cada página, dados estruturados de breadcrumb e nenhuma categoria vazia no ar. Categoria criada para campanha e abandonada é a página órfã mais comum do varejo.
Escala: logs, modelos de página e automação
A partir de dezenas de milhares de URLs, três práticas deixam de ser opcionais. Análise de logs mensal, para ver onde o rastreamento vai e quais modelos de página respondem erro. Correção por modelo, nunca por página: um ajuste no modelo de produto corrige o catálogo. E monitoramento automático, descrito no capítulo “Monitoramento contínuo”. Cada plataforma (VTEX, Shopify, Nuvemshop, Magento ou a própria) resolve parte disso e cria problemas próprios; marketplaces e portais somam o conteúdo gerado por terceiros. SEO programático (páginas geradas em massa a partir de dados) só vale com dado próprio e página útil: a política do Google contra abuso de conteúdo em escala, de março de 2024, atinge páginas geradas em quantidade para manipular o ranqueamento, seja qual for o método.
↗ Na prática
- Escreva a regra de facetas por objetivo: indexar, consolidar versões, impedir indexação ou limitar rastreamento. Aplique por categoria, começando pelas que mais vendem.
- Defina o fluxo do produto esgotado (fica, redireciona, 404) e automatize no CMS.
- Rastreie a loja todo mês e compare com o log: URLs rastreadas que não estão no sitemap são o mapa do desperdício.
- Trate cada erro pelo modelo de página em que ele nasce, para que a próxima publicação não o reabra.
Monitoramento contínuo
SEO técnico se perde mais por regressão do que por falta de projeto: o problema corrigido volta com a próxima publicação, a troca de app ou a nova regra da CDN. Monitorar é descobrir isso no mesmo dia, não no relatório do mês seguinte.
O que monitorar, onde, com que frequência e o alerta
| O que | Onde | Frequência | Alerta |
|---|---|---|---|
| Páginas indexadas, por sitemap | Search Console, relatório de páginas | Semanal | Queda acima do normal em um tipo de página |
| noindex e canônica nas páginas principais | Rastreador agendado | Diária ou a cada publicação | Qualquer mudança em página que vende |
| Erros 5xx e tempo de resposta | Log do servidor e estatísticas de rastreamento | Diária | Pico de erros ou de tempo |
| Robôs atendidos e bloqueados | Logs do servidor e da CDN, com eventos do firewall | Semanal | Rastreador que deveria ter acesso recebe bloqueio; conferir sua identidade |
| Core Web Vitals por modelo de página | Search Console e CrUX | Mensal | Grupo de URL que passa a reprovar |
| Dados estruturados | Search Console, relatórios de aprimoramento | Semanal | Erro novo por tipo |
| Redirecionamentos e 404 com links | Rastreador agendado | Mensal | Cadeia nova ou link interno para 404 |
Search Console e os controles de IA
O Search Console é a fonte oficial do que o Google vê. Desde 31 de agosto de 2026, ele tem, no mundo todo, um controle para incluir ou excluir o site dos recursos de IA generativa da Busca (AI Overviews, AI Mode e Discover); o Google afirma que esse controle não é usado como sinal de ranqueamento nem de inclusão nas outras partes da Busca. O relatório de desempenho de IA generativa, lançado em junho de 2026, mostra as impressões nesses recursos. Os dois estão no Guia de GEO.
Bing e IndexNow
O IndexNow é um protocolo aberto para avisar os buscadores, no momento da publicação, que uma URL foi criada, mudou ou saiu do ar. Bing, Yandex, Naver, Seznam e Yep participam; o Google não. O Bing afirma que o IndexNow ajuda os sistemas de IA a usar a versão mais atual da página, e desde fevereiro de 2026 o Bing Webmaster Tools mostra as citações do site no Copilot e nos resumos de IA do Bing (Bing, fevereiro de 2026). Para quem quer aparecer no Copilot, o Bing Webmaster Tools é tão necessário quanto o Search Console.
A leitura completa das métricas técnicas, ao lado das de negócio, está no Guia de Métricas de SEO e IA.
↗ Na prática
- Agende um rastreamento das páginas que vendem a cada publicação de código, com alerta de noindex, canônica e código de resposta.
- Verifique o site no Bing Webmaster Tools e ative o IndexNow na plataforma ou no CMS, se houver suporte.
- Defina quem recebe cada alerta e em quanto tempo corrige.
- Inclua uma conferência técnica no checklist de toda publicação: robots.txt, noindex, canônica e sitemap.
Os erros que mais custam caro em SEO técnico
Os erros técnicos que mais custam não são os mais difíceis: são os que ninguém vê. Eles se repetem em sites de todos os tamanhos e quase todos têm o mesmo padrão: um sinal visível para quem sabe onde olhar, um custo que ninguém liga à técnica e uma correção que depende mais de processo do que de código.
Os 12 erros e a ação recomendada
Sinal, impacto e ação para os erros recorrentes
| Erro | Sinal | Impacto | Ação e capítulo de apoio |
|---|---|---|---|
| 1. Publicar com o bloqueio da homologação | Queda de indexação após um lançamento | Páginas importantes podem sair da busca | Conferir noindex e robots.txt na publicação; Indexação |
| 2. Bloquear rastreadores sem saber | Bloqueios nos registros da CDN ou do firewall | Conteúdo inacessível aos rastreadores que a empresa quer receber | Cruzar logs e revisar as regras de acesso; Rastreamento |
| 3. Conteúdo dependente de JavaScript | Conteúdo principal ausente antes da execução dos scripts | Acesso depende da capacidade de renderização do rastreador | Conferir a resposta completa e avaliar HTML inicial; Mobile e JavaScript |
| 4. Migrar sem mapa de redirecionamentos | Pico de 404 na virada | Perda de acesso a conteúdo e URLs importantes | Testar o mapa URL a URL contra a linha de base; Migração |
| 5. Redirecionar tudo para a home | Destinos irrelevantes e soft 404 | O usuário perde o conteúdo esperado e os sinais podem não se consolidar | Usar substituto relevante ou sinalizar remoção; HTTPS, 301 e 404 |
| 6. Deixar facetas e parâmetros sem regra | Crescimento de combinações sem utilidade para a busca | Rastreamento consumido em URLs desnecessárias | Definir separadamente indexação, canonical e rastreamento; E-commerce |
| 7. Canônica, sitemap e links em desacordo | Google escolhe uma canônica diferente da pretendida | A versão desejada pode deixar de aparecer | Confirmar a divergência e alinhar os sinais; Indexação |
| 8. Tratar a nota do Lighthouse como meta | Nota alta com Core Web Vitals reprovados no campo | Esforço sem resolver a experiência real | Priorizar dados de campo por modelo; Velocidade e Core Web Vitals |
| 9. Acumular scripts de terceiros | INP piora após novas tags ou integrações | Interações lentas e possível perda de conversão | Manter inventário de scripts com responsável; Velocidade e Core Web Vitals |
| 10. Marcar dados que a página não mostra | Divergência entre marcação e conteúdo visível | Perda de elegibilidade ou ação manual | Gerar marcação coerente com a página; Dados estruturados |
| 11. Corrigir página por página | O mesmo erro reaparece em páginas do mesmo tipo | Retrabalho e correção incompleta | Corrigir o modelo e validar as páginas afetadas; E-commerce e sites grandes |
| 12. Deixar o técnico sem dono | Falhas descobertas apenas no relatório mensal | Demora para corrigir problemas de negócio | Nomear responsáveis e definir alertas; Monitoramento contínuo |
Os mitos que sustentam esses erros
Mitos de SEO técnico e o que vale em 2026
| Mito | O que vale |
|---|---|
| “Nota máxima no PageSpeed garante posição” | Os Core Web Vitals são usados no ranqueamento sem ser sinal único; relevância vem antes, e o que conta é o dado de campo |
| “O sitemap faz a página ser indexada” | O sitemap ajuda a descobrir; indexar depende de qualidade, canônica e links |
| “Bloquear no robots.txt tira do índice” | Bloqueia o rastreamento; a URL pode continuar indexada. Para sair, noindex numa página rastreável |
| “410 tira a página do índice antes do 404” | O Google trata os dois da mesma forma |
| “O Google não lê JavaScript” | O Google pode renderizar a página e executar JavaScript; as capacidades dos rastreadores de IA variam |
| “Dados estruturados fazem ranquear” | Descrevem a página e habilitam resultados ricos, sem garantia de exibição; não há marcação especial para as IAs |
| “Trocar de plataforma resolve o SEO” | A migração é o momento de maior risco; o que resolve são as regras, não a plataforma |
| “Site com HTTPS está resolvido” | HTTPS é o mínimo; certificado vencido, conteúdo misto e versões paralelas do domínio continuam derrubando páginas |
↗ Na prática
- Leia a lista com o seu time de desenvolvimento e marque quais erros já aconteceram na empresa.
- Para cada erro marcado, defina o alerta que o teria pego no primeiro dia.
- Leve a tabela de mitos para a próxima discussão de prioridade técnica.
Checklist de SEO técnico
Este checklist é um diagnóstico em doze passos que um decisor faz com ferramentas gratuitas e com o apoio de quem cuida do site, para saber em que estado está a base técnica. Você precisa de acesso ao Search Console e, para o passo 11, aos registros do servidor, da CDN e do firewall que estiverem no caminho das requisições. Se não tem acesso a uma fonte necessária, essa é uma conclusão a registrar no diagnóstico.
Diagnóstico de SEO técnico em doze passos
| Passo | Onde | O que fazer | O que o resultado significa |
|---|---|---|---|
| 1. Indexação | Search Console, relatório de páginas | Compare páginas indexadas com as que deveriam vender | Muito menos: páginas fora do índice. Muito mais: filtros e duplicatas |
| 2. Páginas que vendem | Search Console, inspeção de URL | Inspecione as dez que mais vendem | Investigue exclusão ou outra canônica; é bloqueador quando impede a presença pretendida da página |
| 3. robots.txt | O endereço /robots.txt do site | Leia as regras de bloqueio e confira a inspeção de URL | É bloqueador quando impede acesso necessário a uma página ou recurso que deveria estar disponível |
| 4. noindex | Código-fonte, cabeçalhos HTTP e inspeção de URL | Procure noindex na meta robots e em X-Robots-Tag | É bloqueador quando impede a indexação pretendida; exclusão intencional deve ser registrada |
| 5. Domínio | Navegador | Abra as versões com e sem www, em HTTP e HTTPS | Todas chegam à mesma versão em um salto |
| 6. Sitemap | Search Console, sitemaps | Confira a última leitura e as páginas enviadas e indexadas | Erro, ou URL que redireciona no sitemap, é ruído |
| 7. JavaScript | Navegador com JavaScript desligado | Abra home, categoria e produto ou serviço | Menu, textos e produtos precisam aparecer |
| 8. Celular | Inspeção de URL e o seu celular | Compare texto, links e informações com o desktop | O que falta no celular não é indexado |
| 9. Core Web Vitals | Search Console, relatório de Core Web Vitals | Veja os grupos de URL reprovados no celular | Modelos que vendem reprovados são prioridade |
| 10. Rastreamento | Search Console, estatísticas de rastreamento | Veja tempo de resposta e erros de servidor | Picos de 5xx explicam quedas de rastreamento |
| 11. Rastreadores | Logs do servidor e da CDN, com eventos do firewall | Cruze os registros de Googlebot, Bingbot e rastreadores de IA; verifique a identidade | Ausência só no log da origem não comprova bloqueio; procure a resposta na CDN ou no firewall |
| 12. Dados estruturados | Search Console, relatórios de aprimoramento | Veja erros por tipo de marcação | Erro bloqueia o recurso; aviso não |
Como ler o resultado
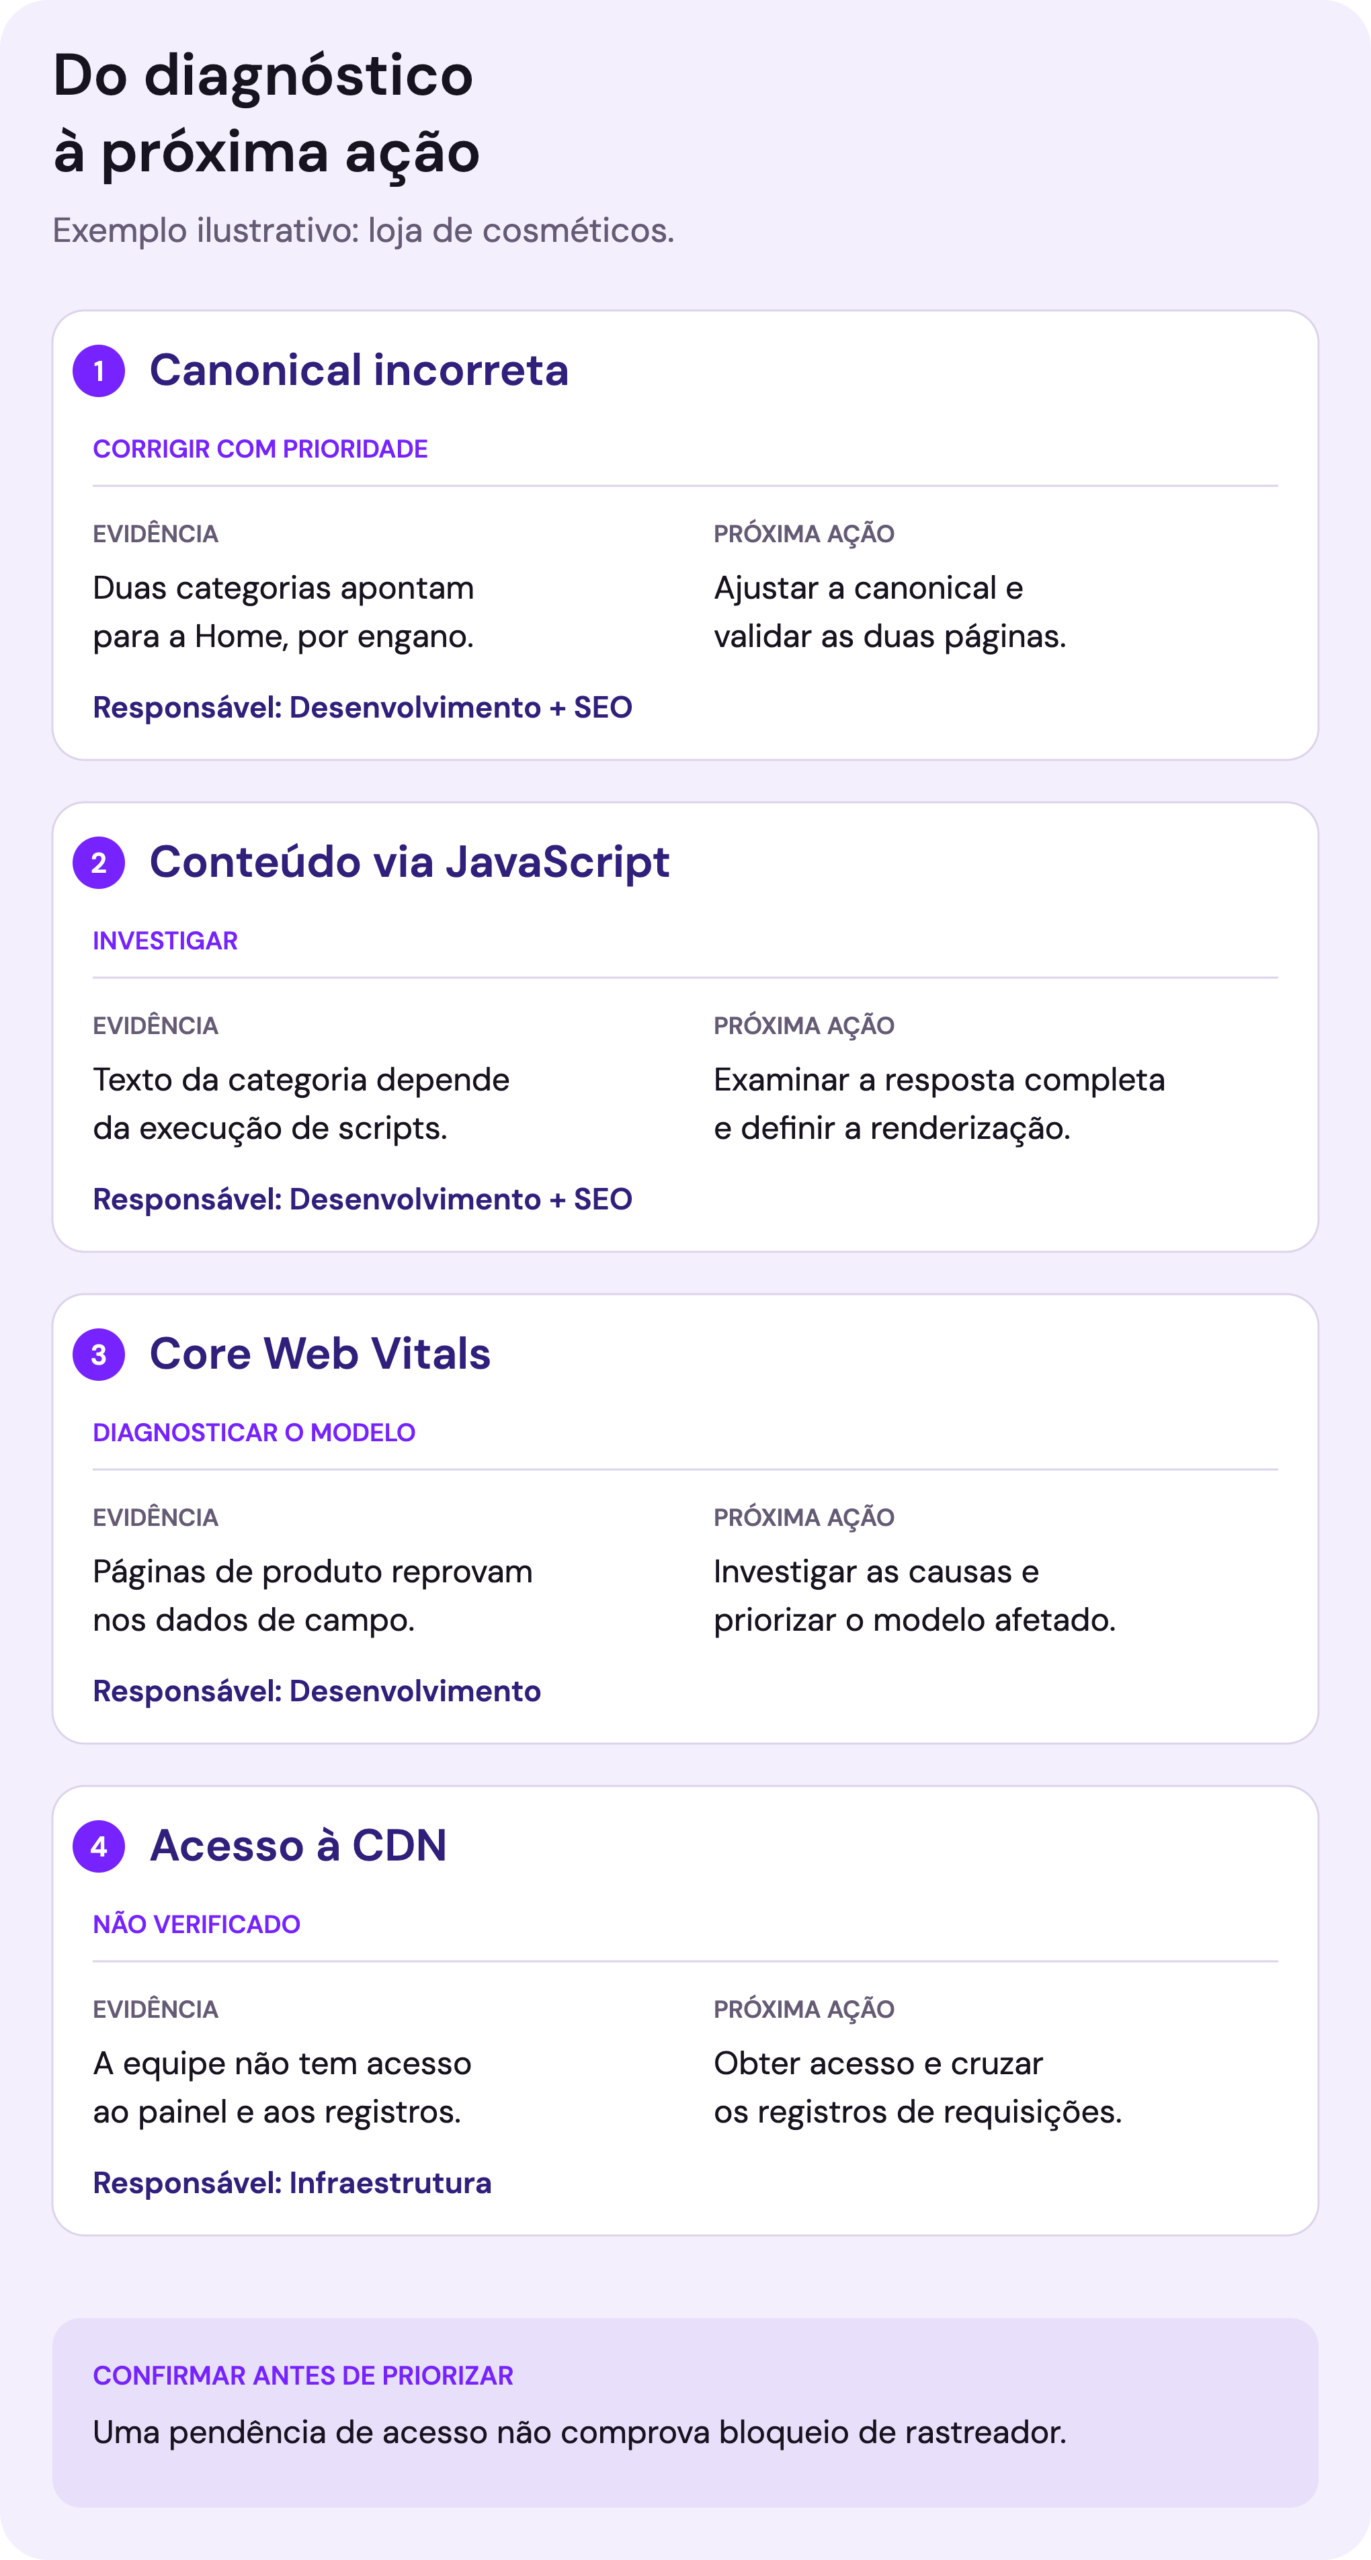
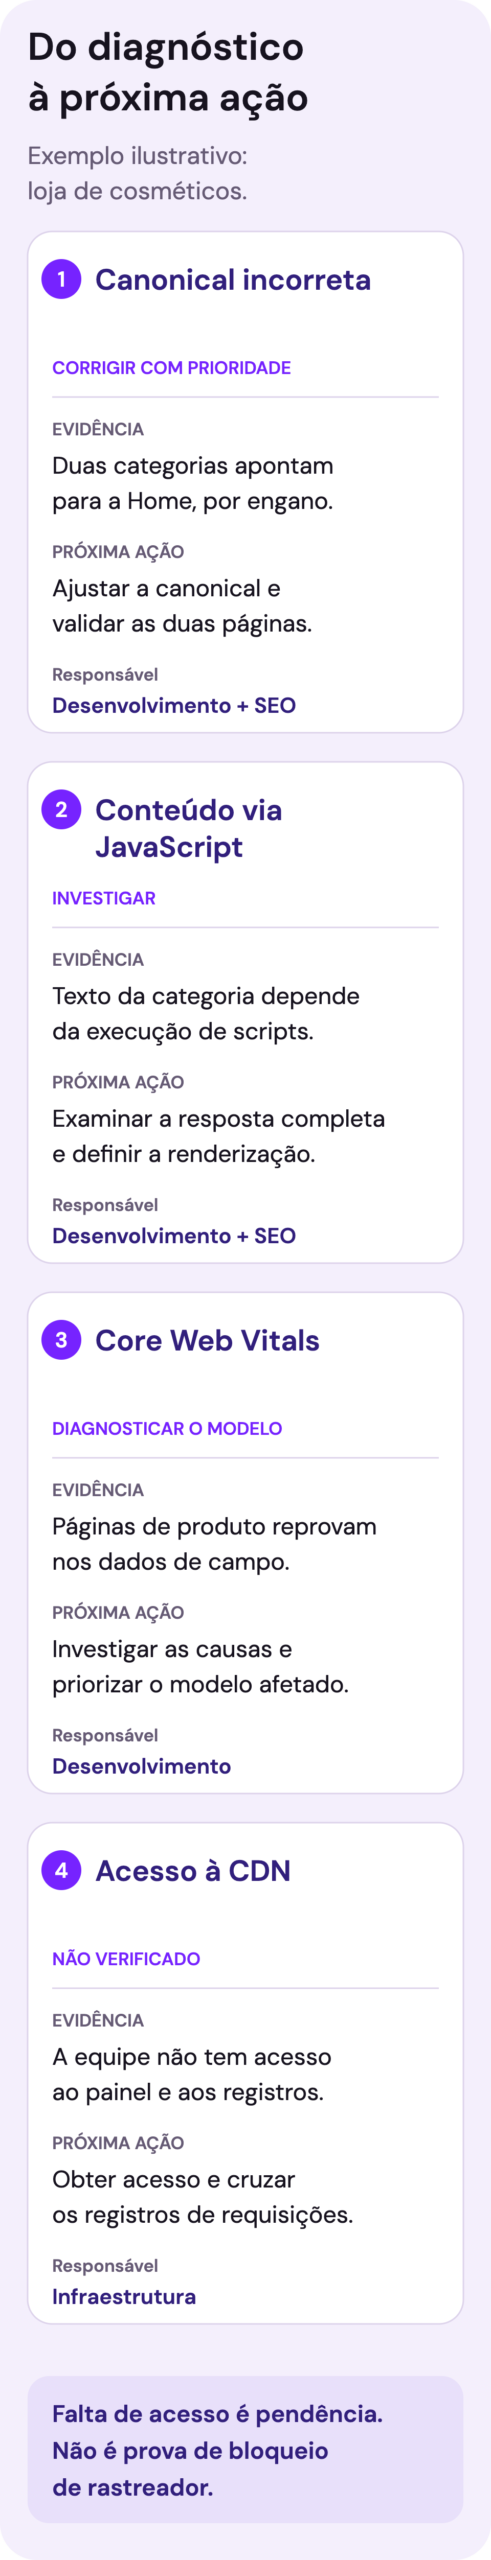
Os passos 1 a 4 ajudam a localizar possíveis bloqueadores, mas uma divergência pede confirmação antes de virar correção urgente. Marque cada achado como configuração intencional, investigar ou corrigir com prioridade. É bloqueador o impedimento confirmado ao acesso, à renderização ou à indexação de uma página que deveria participar da busca. Uma canônica diferente pode estar correta, e um bloqueio pode ter sido planejado. Registre também se o passo foi verificado, não verificado ou não se aplica, com evidência e responsável. A falta de acesso fica como pendência de diagnóstico. Com os bloqueadores confirmados resolvidos, a ordem de trabalho segue o impacto em receita: primeiro o que afeta os modelos de página que vendem.
↗ Na prática
- Faça o checklist com quem cuida do site ao lado: metade dos passos depende de um acesso que o decisor não tem.
- Registre a evidência de cada passo (print, número, data) para comparar no mês seguinte.
- Repita o checklist depois de toda migração, troca de tema ou de CDN.
Os primeiros 90 dias
Os primeiros 90 dias de um trabalho técnico decidem o ano: é quando a base que faz o resultado aparecer é construída e quando os bloqueadores saem do caminho. Este capítulo descreve o que precisa acontecer nesse período, seja com uma agência, uma consultoria ou a equipe interna, e serve para o decisor cobrar o certo na hora certa.
O roteiro técnico dos primeiros 90 dias
| Período | Frente | O que acontece | Entregável | Como cobrar |
|---|---|---|---|---|
| Semana 1 | Acessos e linha de base | Search Console, Bing Webmaster Tools, GA4, log do servidor, CDN e homologação; linha de base de indexação, Core Web Vitals, erros e tráfego por tipo de página | Documento de linha de base | “Qual é o número de hoje de cada coisa que vamos medir?” |
| Semanas 2 a 4 | Diagnóstico | Rastreamento do site inteiro, log, renderização, paridade mobile, redirecionamentos e dados estruturados; bloqueadores corrigidos assim que confirmados | Lista priorizada por impacto em receita e esforço | “O que impede o resultado hoje, em ordem de impacto?” |
| Mês 2 | Regras | Regras de indexação (facetas, parâmetros, variações, esgotados), arquitetura e links internos | Regras escritas e especificações por modelo de página | “Que regra decide o que entra no índice?” |
| Mês 2 | Correções por modelo | Canônicas, sitemaps por tipo, códigos de resposta, renderização no servidor nos modelos que vendem | Correções publicadas e validadas em produção | “Quantas correções especificadas já estão no ar?” |
| Mês 3 | Velocidade e marcação | Core Web Vitals por modelo, inventário de scripts, dados estruturados | Modelos aprovados no campo e marcação sem erro | “Quais modelos passaram nos Core Web Vitals?” |
| Mês 3 | Monitoramento | Rastreamento semanal e alertas de noindex, canônica, 5xx e queda de indexação | Painel e alertas ativos | “Quem recebe o alerta e em quanto tempo corrige?” |
| Todo mês | Relatório | Comparação com a linha de base | Relatório em linguagem de negócio | “O que mudou desde a linha de base?” |
O que a sua empresa precisa dar
O técnico só anda na velocidade do que chega à produção. Antes de começar, garanta:
- Horas de desenvolvimento reservadas todo mês para as correções especificadas, com prioridade combinada; sem isso, o mês 2 não acontece.
- Acesso ao log do servidor e ao painel da CDN, além do Search Console e do GA4.
- Um ambiente de homologação onde as correções sejam testadas antes de publicar.
- Um dono interno com autoridade para decidir prioridade entre SEO, campanhas e demandas do site.
- Aviso prévio de qualquer migração, troca de tema, de app ou de CDN, antes de a data ser decidida.
- Uma conferência técnica no checklist de toda publicação.
Quem faz
A equipe interna conhece o site e a plataforma; o fornecedor especializado traz método, ferramentas e a experiência de muitos sites. Na maioria das empresas, os dois trabalham juntos: quem especifica e valida precisa de acesso direto a quem publica. Os critérios para escolher entre agência, consultoria e equipe interna estão no Guia para Contratar SEO.
↗ Na prática
- Peça o documento de linha de base na primeira semana, com os números de hoje.
- Cobre a lista de bloqueadores no fim do primeiro mês e a correção deles logo que forem confirmados.
- No fim do terceiro mês, compare cada número com a linha de base e decida o plano do trimestre seguinte.
Resultados do método
Valid, Flexdoc, Contato Seguro, Sem Parar e Polishop estão entre as marcas atendidas pela TRIWI.
Como a TRIWI faz SEO Técnico
A TRIWI faz uma coisa só, SEO com Otimização para IAs, com uma equipe de mais de 30 profissionais seniores e uma metodologia própria de 12 etapas e mais de 300 atividades, organizadas em cinco fases. Atua com SEO desde 2018. A otimização técnica é uma das entregas fixas do escopo, não um projeto à parte: atravessa as cinco fases e é acompanhada semana a semana, porque cada publicação de código pode reabrir um problema fechado.
As cinco fases
As cinco fases do método da TRIWI aplicadas ao SEO técnico
| Fase | O que acontece | O que o cliente recebe | Quando |
|---|---|---|---|
| Diagnóstico e auditoria | Auditoria em todas as frentes deste guia: rastreamento do site inteiro, log do servidor, indexação, Core Web Vitals de campo, dados estruturados, renderização, paridade mobile, redirecionamentos, segurança, sitemaps e acesso dos rastreadores de busca e de IA; cada achado com impacto estimado em receita e esforço de correção | Linha de base e lista priorizada de correções | Primeiro mês |
| Definição estratégica | Arquitetura e regras de indexação (facetas, parâmetros, variações, conteúdo) a partir da pesquisa de palavras-chave e da jornada do cliente; especificações escritas para quem implementa; metas de negócio antes das metas técnicas | Regras de indexação, especificações e metas | Primeiro e segundo mês |
| Implementação | Correções especificadas pela TRIWI e implementadas com o apoio da nossa equipe, em contato direto com o seu time ou a sua agência de desenvolvimento; teste em homologação e conferência em produção, com a evidência registrada | Correções publicadas e validadas | Bloqueadores assim que confirmados; o restante do segundo mês em diante, contínuo |
| Monitoramento | Rastreamento recorrente; alertas de noindex, canônica, redirecionamento, 5xx e queda de indexação; Core Web Vitals de campo, log do servidor, Search Console e Bing Webmaster Tools | Painéis com acesso do cliente e relatório mensal em linguagem de negócio | Toda semana; relatório mensal |
| Otimização | Ciclo PDCA (planejar, executar, checar, agir) mensal, com microcorreções constantes; troca de plataforma, tema ou CDN tratada como projeto de migração, com linha de base e checklist | Plano do mês seguinte, com o que mudou e por quê | Todo mês |
A TRIWI especifica cada correção e apoia a implementação junto ao seu time ou à sua agência de desenvolvimento, com a nossa equipe em contato direto com os desenvolvedores, do ajuste no código à configuração da plataforma. Toda correção é testada em homologação e conferida em produção, com a evidência registrada (inspeção de URL, log, relatório).
Prazos, relatório e relação
Como média do mercado, o SEO mostra os primeiros sinais entre 3 e 6 meses e consolida o retorno entre 6 e 12 meses, e o prazo varia com quem executa: equipe interna, fornecedor qualificado ou não. Nos projetos que a TRIWI conduz, os primeiros resultados no Google e nas IAs aparecem já no segundo mês, com aceleração a partir do terceiro e consolidação a partir do quarto; o que encurta o prazo é experiência, qualificação e conhecimento de mercado, e ele varia de projeto para projeto. Na técnica, o efeito costuma vir antes: página que volta ao índice ou categoria liberada de um bloqueio pode voltar a ranquear em semanas.
Relatório mensal em linguagem de negócio: leads, pedidos, receita influenciada e CAC, com indexação, Core Web Vitals, posição e tráfego como apoio. Você tem acesso aos painéis e sabe o que foi feito em cada atividade e por quê. Equipe sênior, dedicada, como extensão do seu time de marketing e de tecnologia. Sem contrato de fidelidade: aviso prévio de 30 dias, sem multa, e todo o trabalho (auditorias, especificações, regras, mapas de redirecionamento) fica como propriedade da sua empresa.
Para quem é
Empresas que respondem por venda, lead e CAC e cujo site é peça central da operação: e-commerce de qualquer plataforma, tecnologia e SaaS, varejo com rede de lojas, indústria com catálogo grande, serviços com muitas unidades, portais e marketplaces, e qualquer empresa prestes a migrar de plataforma, domínio ou marca. Não é para quem precisa de resultado em 30 dias.
↗ Na prática
- Leve para a primeira conversa o acesso ao Search Console e ao log do servidor: o diagnóstico começa por eles.
- Apresente à TRIWI quem responde pelo código e pela plataforma do seu lado: a TRIWI apoia a implementação, e o contato direto com essas pessoas encurta o caminho.
- Avise sobre qualquer migração, troca de tema ou de CDN prevista antes de decidir a data.
Perguntas frequentes
SEO técnico resolve sozinho o ranqueamento?
Não. Ele é o piso: remove o que impede o Google e as IAs de ler, indexar e entender o site. Posição e citação vêm dos outros três pilares: conteúdo, autoridade e Otimização para IAs. A ordem importa: corrigir a técnica antes libera o valor do que já existe e evita investir em conteúdo que o índice não vai receber.
Minha plataforma (VTEX, Shopify, Nuvemshop, WordPress) já cuida do SEO técnico?
Em parte. Toda plataforma entrega o básico (URLs, sitemap, metas, redirecionamentos, HTTPS) e cria problemas próprios: URLs de filtro e de busca, variações de produto, temas e apps pesados, dados estruturados errados vindos do tema. O que a plataforma não decide, e ninguém decide no lugar da empresa, é a regra: o que indexar, o que bloquear, como organizar o catálogo. As páginas SEO para VTEX, SEO para Shopify e SEO para Nuvemshop mostram o que cada plataforma entrega e o que depende de SEO.
Site feito em JavaScript (React, Next.js, Vue, Angular) ranqueia?
Sim. O Google consegue processar páginas com JavaScript, inclusive quando parte do conteúdo é montada no navegador, desde que consiga acessar e renderizar os recursos necessários. Entregar o conteúdo principal no HTML inicial, por renderização no servidor, geração estática ou pré-renderização, reduz essa dependência e facilita o acesso de rastreadores que não executam scripts. As capacidades variam entre plataformas de IA. A escolha do framework importa menos do que a configuração e a validação do que cada rastreador recebe.
Quem implementa as correções, a TRIWI ou o meu time de desenvolvimento?
A TRIWI diagnostica, especifica, prioriza e apoia a implementação junto ao seu time ou à sua agência de desenvolvimento, em contato direto com os desenvolvedores, e valida cada correção em produção. Em plataformas proprietárias e em e-commerce, parte dos ajustes passa por quem administra a plataforma, e a TRIWI acompanha esse trabalho do pedido à validação. O conhecimento do site continua com quem o opera.
Ainda vale investir em dados estruturados se o Google tirou vários resultados ricos?
Vale, por outro motivo. Os resultados ricos encolheram (o de perguntas frequentes deixou de aparecer em maio de 2026), mas a marcação continua sendo a forma mais limpa de descrever a empresa, o produto e o autor para o Google, e Product, Article, Organization e BreadcrumbList seguem com uso na busca. Marcação coerente com o texto visível é parte da entidade consistente que o Google e as IAs encontram.
Vou perder posições na migração?
A meta é preservar a visibilidade, mas uma migração pode produzir oscilações enquanto o Google processa as mudanças. O risco diminui quando o SEO participa antes da arquitetura, existe um mapa de redirecionamentos URL a URL e a homologação é rastreada e comparada com o site atual. Queda persistente exige investigação: conferir implementação, conteúdo, demanda de busca e possíveis atualizações dos sistemas do Google antes de atribuir a causa à execução. A linha de base ajuda a separar esses fatores.
Quanto tempo leva?
Correção técnica mostra efeito antes dos outros pilares: uma página que volta ao índice ou uma categoria liberada de um bloqueio pode voltar a ranquear em semanas. Como média do mercado, o resultado de negócio do SEO aparece entre 3 e 6 meses (primeiros sinais) e se consolida entre 6 e 12 meses, porque depende também de conteúdo e autoridade, e varia com quem executa. Nos projetos conduzidos pela TRIWI, os primeiros resultados no Google e nas IAs aparecem já no segundo mês, com aceleração a partir do terceiro e consolidação a partir do quarto, com variação de projeto para projeto.
Como vocês medem o resultado?
Leads, pedidos, receita influenciada pelo orgânico e CAC, em relatório mensal, com indexação, Core Web Vitals, posição e tráfego orgânico como apoio. Posição e tráfego são meio, não fim.
Tem contrato de fidelidade?
Não. Aviso prévio de 30 dias, sem multa, e todo o trabalho fica como propriedade da sua empresa.
- Outubro de 2026: publicação do guia, com o levantamento técnico da TRIWI sobre as páginas do topo do Google no Brasil (três buscas comerciais em cada um de dez setores, celular, São Paulo, 150 páginas lidas com e sem JavaScript em 21 de outubro de 2026), a documentação do Google Search Central e do Google Crawling na versão de outubro de 2026 e os dados do HTTP Archive (Web Almanac 2025), do Cetic.br, dos estudos de caso do web.dev, da Deloitte, da Vercel e MERJ, da Ahrefs e da Cloudflare.
- TRIWI, levantamento técnico das páginas do topo do Google: três buscas comerciais em cada um de dez setores (saúde, finanças, software, contabilidade, jurídico, imóveis, educação, seguros, indústria e e-commerce); Google, celular, localização São Paulo (SP), coleta em 21 de outubro de 2026 pela API de SERP da DataForSEO; cinco primeiros resultados orgânicos de cada busca, totalizando 150 URLs submetidas a tentativas de leitura pela API On-Page sem e com execução de JavaScript. Comparação entre 117 páginas com resposta HTTP 200 e contagem de palavras disponível nos dois modos. Resultados e limites nos blocos “Levantamento técnico TRIWI” deste guia.
- TRIWI, indicadores da carteira ativa de clientes (2026) e case Valid e Flexdoc: /cases/ ↗ e /cases/valid-flexdoc/ ↗
- DataForSEO, APIs de SERP e On-Page usadas na coleta Consultar fonte ↗
- Google Search Central, Googlebot Consultar fonte ↗
- Google Search Central, como a Busca funciona Consultar fonte ↗
- Google Search Central, guia inicial de SEO Consultar fonte ↗
- Google Search Central, redirecionamentos Consultar fonte ↗
- Google Search Central, consolidação de URLs duplicadas Consultar fonte ↗
- Google Search Central, impedir indexação com noindex Consultar fonte ↗
- Google Search Central, dados estruturados para snippets de produto Consultar fonte ↗
- Google Search Central, diagnóstico de quedas de tráfego Consultar fonte ↗
- OpenAI, rastreadores e mecanismos de acesso Consultar fonte ↗
- Cloudflare, registros de requisições HTTP na CDN Consultar fonte ↗
- Google Crawling, visão geral dos rastreadores e cache HTTP Consultar fonte ↗
- Google Crawling, códigos de status HTTP Consultar fonte ↗
- Google Crawling, reduzir a taxa de rastreamento Consultar fonte ↗
- Google Crawling, especificação do robots.txt Consultar fonte ↗
- Google Crawling, orçamento de rastreamento Consultar fonte ↗
- Google Crawling, navegação facetada (dezembro de 2024) Consultar fonte ↗
- Google Search Central, CDNs e rastreamento (dezembro de 2024) Consultar fonte ↗
- Google Search Central, criar um sitemap Consultar fonte ↗
- Google Search Console, relatório de indexação de páginas Consultar fonte ↗
- Google Search Central, JavaScript SEO Consultar fonte ↗
- Google Search Central, links rastreáveis Consultar fonte ↗
- Google Search Central, indexação mobile-first Consultar fonte ↗
- Google Search Central, experiência de página Consultar fonte ↗
- Google Search Central, intersticiais intrusivos Consultar fonte ↗
- web.dev, Core Web Vitals Consultar fonte ↗
- Google Search Central, galeria de dados estruturados Consultar fonte ↗
- Google Search Central, atualizações da documentação Consultar fonte ↗
- Google Search Central, variações de produto Consultar fonte ↗
- Google Search Central, dados estruturados de Article Consultar fonte ↗
- Google Search Central, recursos de IA e o seu site Consultar fonte ↗
- Google Search Central, migração com mudança de URL Consultar fonte ↗
- Google Search Central, paginação e carregamento incremental Consultar fonte ↗
- Google Search Central, versões localizadas da página (hreflang) Consultar fonte ↗
- Google Search Central, sites multirregionais e multilíngues Consultar fonte ↗
- Google Search Central, políticas de spam Consultar fonte ↗
- Google Search Console, controle de IA generativa da Busca Consultar fonte ↗
- Google Search Central, relatórios de desempenho de IA generativa (junho de 2026) Consultar fonte ↗
- Google Online Security Blog, HTTPS by default (outubro de 2025) Consultar fonte ↗
- Microsoft, Copilot e a busca do Bing Consultar fonte ↗
- Bing, AI Performance no Bing Webmaster Tools (fevereiro de 2026) Consultar fonte ↗
- IndexNow Consultar fonte ↗
- OpenAI, ChatGPT search Consultar fonte ↗
- HTTP Archive, Web Almanac 2025, Performance Consultar fonte ↗
- HTTP Archive, Web Almanac 2025, SEO Consultar fonte ↗
- HTTP Archive, Web Almanac 2025, Ecommerce Consultar fonte ↗
- HTTP Archive, Web Almanac 2025, Page Weight Consultar fonte ↗
- web.dev, estudo de caso Nuvemshop (junho de 2026) Consultar fonte ↗
- web.dev, estudo de caso QuintoAndar (janeiro de 2025) Consultar fonte ↗
- web.dev, estudo de caso Vodafone (março de 2021) Consultar fonte ↗
- Deloitte, Milliseconds Make Millions (março de 2020) Consultar fonte ↗
- Vercel e MERJ, The rise of the AI crawler (dezembro de 2024) Consultar fonte ↗
- Cetic.br, TIC Domicílios 2025 (dezembro de 2025) Consultar fonte ↗
- Cloudflare Radar, retrospectiva 2025 (dezembro de 2025) Consultar fonte ↗
- Cloudflare, bloqueio padrão de rastreadores de IA (julho de 2025) Consultar fonte ↗
- Ahrefs, estudo de auditoria de sites (agosto de 2023) Consultar fonte ↗
- Ahrefs, estudo de hreflang (agosto de 2023) Consultar fonte ↗
- Ahrefs, bloqueio de robôs de IA (maio de 2025) Consultar fonte ↗